


BIOS «Рикор» вылетел из реестра российского ПО из-за неактуальных данных

BIOS «Рикор» вылетел из реестра российского ПО из-за неактуальных данных

BIOS «Рикор» вылетел из реестра российского ПО из-за неактуальных данных

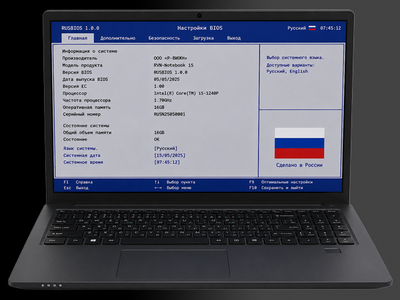
Из реестра российского программного обеспечения исключили BIOS компании «Рикор». Запись удалили по поручению Минцифры от 12 мая 2026 года. Формальная причина звучит так: сведения в реестре стали неактуальными, а правообладатель не ответил на запрос ведомства об их обновлении.

В Минцифры пояснили, что направляли компании запрос о необходимости актуализировать данные. Ответа не последовало, поэтому по правилам ведения реестра продукт можно было исключить.

Речь идёт не о рядовой утилите, а о BIOS — низкоуровневом системном ПО, которое первым просыпается при включении устройства, инициализирует оборудование и запускает дальнейшую загрузку.

Для производителей серверов, десктопов и промышленной техники наличие отечественной системы ввода-вывода может быть важным аргументом в закупках, особенно государственных.

«Рикор» объявил о создании российского аналога BIOS ещё в 2018 году, а в реестр российского ПО продукт внесли в 2023-м. Исключённая версия была совместима со спецификацией UEFI и предназначалась для ноутбуков, моноблоков, персональных компьютеров, промышленных ПК, тонких клиентов и других устройств на базе x86-процессоров AMD и Intel.

В самой компании заявили, что старая запись действительно потеряла актуальность. По словам гендиректора «Рикор Групп» Бориса Иванова, из продуктовой линейки убрали серверы на базе AMD, а сейчас вводят серверы на Intel Xeon Gen4/Gen5. Кроме того, разработку ПО выделили в отдельное юрлицо — «Рикор ИИ».

Продлевать реестровую запись от 1 марта 2023 года компания не планирует. Новые заявки в Минцифры, включая ПО базового ввода-вывода, «Рикор» собирается подавать уже от имени «Рикор ИИ».

По данным CNews, в реестре Минцифры сейчас остаётся больше трёх десятков вариантов российских BIOS. При этом участники рынка признают: часть решений может быть создана на базе зарубежного исходного кода с доработками под конкретные устройства.

Ошибочная раскладка помогла обойти первый рубеж защиты GPT-6 Astra

Разработчик под ником vechen обнаружил странность в GPT-6 Astra: модель понимает русский и украинский текст, случайно набранный в английской раскладке, но система предварительной модерации может увидеть в нём лишь безобидную кашу из букв.

В опубликованном эксперименте GPT-6 Astra High без дополнительных инструкций распознала смысл фразы, введённой латиницей вместо кириллицы.

Затем исследователь проверил слова и запросы, которые потенциально должны привлекать внимание защитных механизмов. В одном из тестов модель согласилась помочь со взломом сайта под предлогом проверки собственного ресурса, хотя аналогичный запрос в нормальной раскладке должен проходить более строгую проверку.

Причина, предположительно, в разделении системы на несколько уровней. Сначала входной фильтр анализирует текст пользователя, после чего сама модель интерпретирует запрос и формирует ответ.

 

Впрочем, до полноценного джейлбрейка не дошло. Проверка «Код.ру» показала, что неправильная раскладка действительно может помочь опасному запросу добраться до модели, но финальный фильтр блокирует запрещённый ответ.

Метод работает не со всеми языковыми парами. Кириллический текст, набранный латиницей, Astra распознаёт стабильно, а сочетание английской и турецкой раскладок в тестах не сработало. Похожее поведение исследователь заметил и у Fable 5.

Напомним, на прошлой неделе мы писали, что первые пользователи GPT-6 Astra заметили, что модель распараллеливает задачи и нагружает компьютеры кучей процессов.

RSS: Новости на портале Anti-Malware.ru