


287 расширений для Chrome с 37 млн шпионили за пользователями

287 расширений для Chrome с 37 млн шпионили за пользователями

287 расширений для Chrome с 37 млн шпионили за пользователями

Исследователи безопасности обнаружили 287 расширений для Google Chrome, которые, по их данным, тайно отправляли данные о посещённых пользователями сайтах на сторонние серверы. Суммарно такие расширения были установлены около 37,4 млн раз, что равно примерно 1% мировой аудитории Chrome.

Команда специалистов подошла к проверке не по описаниям в магазине и не по списку разрешений, а по фактическому сетевому поведению.

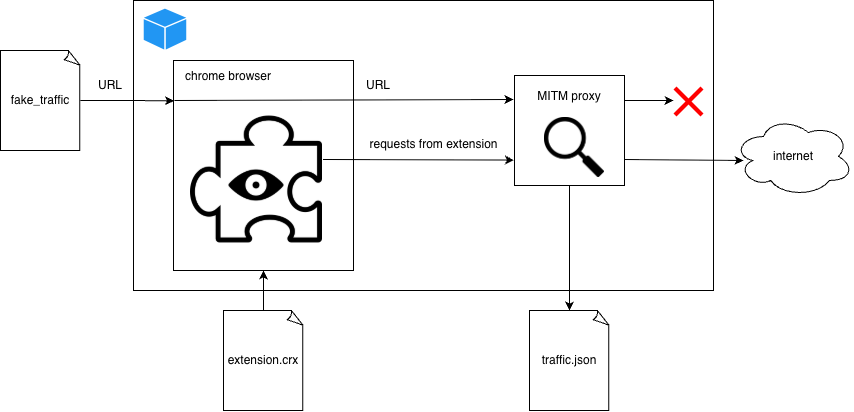
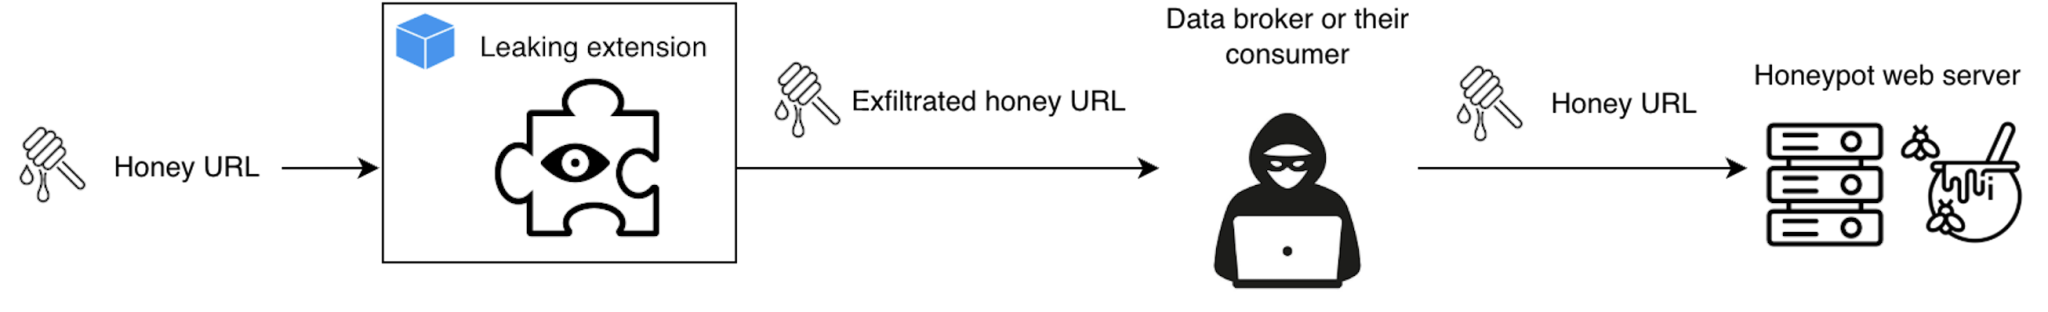
Для этого исследователи запустили Chrome в контейнере Docker, пропустили весь трафик через MITM-прокси и начали открывать специально подготовленные URL-адреса разной длины. Идея была простой: если расширение «безобидное» — например, меняет тему или управляет вкладками — объём исходящего трафика не должен расти вместе с длиной посещаемого URL.

А вот если расширение передаёт третьей стороне полный адрес страницы или его фрагменты, объём трафика начинает увеличиваться пропорционально размеру URL. Это измеряли с помощью собственной метрики. При определённом коэффициенте расширение считалось однозначно «сливающим» данные, при более низком — отправлялось на дополнительную проверку.


Работа оказалась масштабной: на автоматическое сканирование ушло около 930 процессорных дней, в среднем по 10 минут на одно расширение. Подробный отчёт и результаты опубликованы в открытом репозитории на GitHub, хотя авторы намеренно не раскрыли все технические детали, чтобы не облегчать жизнь разработчикам сомнительных аддонов.

Среди получателей данных исследователи называют как крупные аналитические и брокерские экосистемы, так и менее известных игроков. В отчёте фигурируют, в частности, Similarweb, Big Star Labs (которую авторы связывают с Similarweb), Curly Doggo, Offidocs, а также ряд других компаний, включая китайские структуры и небольших брокеров.

Проблема не ограничивается абстрактной «телеметрией». В URL могут содержаться персональные данные, ссылки для сброса паролей, названия внутренних документов, административные пути и другие важные детали, которые могут быть использованы в целевых атаках.


Пользователям советуют пересмотреть список установленных расширений и удалить те, которыми они не пользуются или которые им незнакомы. Также стоит обращать внимание на разрешение «Читать и изменять данные на всех посещаемых сайтах» — именно оно открывает путь к перехвату URL.

Яндекс с нуля обучил полностью суверенную языковую модель

Яндекс представил Alice AI Foundation LLM — базовую версию новой языковой модели, полностью обученной с нуля. Компания самостоятельно собрала корпус, выбрала архитектуру и гиперпараметры, не используя готовые зарубежные модели.

Как сообщают «Ведомости», Alice AI Foundation содержит 80 млрд параметров и обучена на 18 трлн токенов. Благодаря архитектуре Mixture of Experts при обработке каждого токена активируются только 3 млрд параметров — весь 80-миллиардный коллектив одновременно будить не приходится. Контекстное окно достигает 262 144 токенов.

По внутренним тестам Яндекса, модель делит лидерство с Qwen3.5-35B-A3B-Base на задачах AIME 2026 и превосходит Nemotron-3-Super-120B-A12B-Base в ряде тестов на программирование, используя в четыре раза меньше активных параметров. В русскоязычных фактологических заданиях она также обошла более крупную DeepSeek-V4-Flash-Base с 284 млрд параметров. Впрочем, результаты получены на инфраструктуре самой компании и ещё нуждаются в независимой проверке.

Для оценки знаний, актуальных русскоязычной аудитории, Яндекс разработал бенчмарки WikiWebFacts и HardMultiQA. Первый проверяет знание дат, событий, определений и персоналий, второй — умение работать со сложными вопросами из медицины, права, ИТ и искусства. Наборы заданий, эталонные ответы и протоколы оценки опубликованы вместе с моделью.

Инженеры также переработали оптимизатор, совместив обмен данными между видеокартами с вычислениями и примерно вдвое ускорив шаги оптимизации. Каскад классификаторов сократил затраты на отбор обучающих документов в десятки раз, сохранив около 95% полезных материалов.

Веса, технические материалы и бенчмарки уже доступны на Hugging Face под Apache 2.0. Но это претрейн, а не готовый чат-бот: перед внедрением модель придётся дообучить и настроить. В будущем она станет полигоном для единой рассуждающей модели и ИИ-агентов «Алисы».

Яндекс называет разработку полностью суверенной, однако официальный порядок присвоения такого статуса в России заработает только в марте 2027 года.

RSS: Новости на портале Anti-Malware.ru