


Новая звуковая атака вытащит набранный текст даже в шумном помещении

Новая звуковая атака вытащит набранный текст даже в шумном помещении

Новая звуковая атака вытащит набранный текст даже в шумном помещении

Специалисты показали в деле новый вектор звуковой атаки по сторонним каналам. С её помощью условный злоумышленник может вычислить клавиши. которые нажимает пользователь, учитывая его паттерны ввода. Говорят, метод работает даже в шумных помещениях.

Новый вектор, стоит признать, демонстрирует менее впечатляющие результаты, чем, например модель обучения, продемонстрированная летом 2023 года (с точностью в 95%).

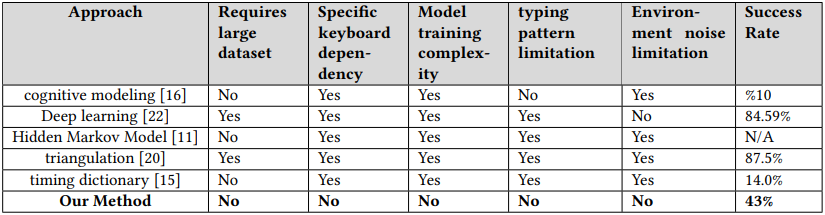
В ходе тестирования свежей находки исследователям удалось добиться лишь 43% удачных попыток. Тем не менее есть и плюсы: вектор не зависит от благоприятных для записи звука условий и конкретной платформы для набора текста.

Другими словами, новый способ можно легче задействовать в реальных атаках, при этом он способен предоставить вполне пригодные для дешифровки данные. Исследователи провели сравнение, результаты которого можно посмотреть в таблице:


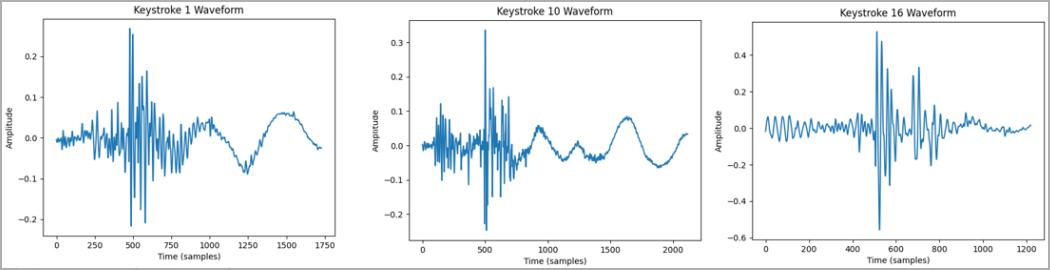
Согласно техническому анализу (PDF), недавно обнаруженный вектор атаки берёт в оборот звуки, издаваемые разными клавишами клавиатуры, а также паттерны набора текста. Всё это фиксируется специальным софтом, помогающим собрать данные.

Для успеха атаки необходимо добыть несколько образцов набора текста целевого пользователя и соотнести отдельные клавиши и целые слова с соответствующими звуковыми волнами.

В отчёте исследователей описываются несколько способов сбора такой информации. Например, можно использовать вредоносные программы, сайты или расширения для браузера.


Теперь о том, что выделяет этот вектор атаки. Она сработает даже в том случае, если:

  • в полученных записях присутствуют шумы окружающей среды;
  • записи содержат звук, полученный от разных моделей клавиатур;
  • записи сделаны через плохой микрофон;
  • потенциальная жертва использует разные стили набора текста.
Подпишитесь на новости

Греф объяснил, почему российский ИИ отстаёт от Китая на полгода

Российские ИИ-модели отстают от китайских примерно на полгода, а Китай — на столько же от США. Такой технологический расклад представил глава Сбербанка Герман Греф на конференции «ГигаКонф 2026». Главной причиной отставания России он назвал ограниченный доступ к вычислительным мощностям.

Китайские разработчики, по его словам, таких проблем практически не испытывают и могут обучать модели без аналогичных инфраструктурных ограничений.

«Мы находимся в неравных условиях с китайскими компаниями, у которых фактически сегодня нет никаких ограничений в мощностях. По всем остальным параметрам, я считаю, мы ничем не уступаем», — заявил Греф.

Глава Сбербанка ожидает, что разрыв сохранится и в дальнейшем. Получается своеобразная очередь: российские модели догоняют китайские, китайские — американские, а владельцы дата-центров тем временем могут спокойно повышать цены на вычисления.

На этом фоне российский бизнес всё активнее использует зарубежные LLM. В 2026 году потребление таких моделей на крупнейших отечественных облачных платформах выросло в несколько раз, причём основной спрос сместился в сторону китайских Qwen и DeepSeek.

Оно и понятно: модели из КНР предлагают достойное качество, стоят дешевле западных аналогов и зачастую позволяют развернуть решение в собственном контуре.

RSS: Новости на портале Anti-Malware.ru