



В Сеть выложили технические детали опасной дыры в ядре Linux — StackRot

В Сеть выложили технические детали опасной дыры в ядре Linux — StackRot

В Сеть выложили технические детали опасной дыры в ядре Linux — StackRot

В Сети появились технические подробности серьёзной уязвимости, затрагивающей множество версий ядра Linux. Брешь получила имя StackRot, её можно использовать для повышения прав в атакованной системе.

Специалисты отмечают, что эксплуатация бага, получившего идентификатор CVE-2023-3269 потребует определённых усилий. Патч доступен с 1 июля, а полностью рабочий демонстрационный эксплойт обещают к концу месяца.

За обнаружение уязвимости благодарят исследователя Руихана Ли. Как объяснил эксперт, проблема затрагивает подсистему управления памятью ядра. Этот компонент, как известно, отвечает за имплементацию виртуальной памяти, её выделение для нужд ядра и программ уровня пользователя.

StackRot актуальна для всех конфигураций ядра в версиях Linux с 6.1 по 6.4. Исследователь сообщил о баге 15 июня, однако подготовка патча заняла почти две недели из-за сложности проблемы. Говорят, что даже сам Линус Торвальдс возглавил работу.

«28 июня патч добавили в дерево Линуса. Сам Линус предоставил обстоятельное сообщение, чтобы прояснить заплатки с технической точки зрения. Далее патчи были портированы на стабильные версии ядра (6.1.37, 6.3.11 и 6.4.1). Таким образом, “StackRot“ удалось полостью устранить первого июля», — отмечает Ли.

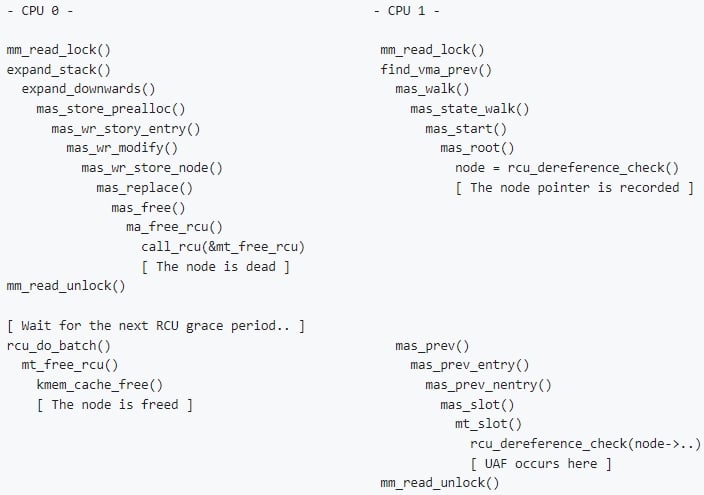
В целом причину возникновения этого бага эксперты видят в методе обработки расширения стека со стороны ядра Linux. Само «слабое звено» располагается в «maple tree» — новой структуре данных для VMA, которая была представлена в ядре Linux версии 6.1.

Фактически StackRot можно назвать классической UAF (use-after-free — некорректное использование динамической памяти), возникающей из-за метода обработки расширения стека.


Руихан Ли подчеркнул, что грамотная эксплуатация может стать серьёзной задачей, а CVE-2023-3269, в сущности, будет первой теоретически эксплуатируемой дырой класса use-after-free-by-RCU (UAFBR). Сам proof-of-concept (PoC) эксперт обещает выложить к концу июля.

Подпишитесь на новости

Codex и Kimi провалили задачи после перевода промптов на русский

Попросили ИИ исправить код по-русски, а он сразу же решил обойтись без интернета и начал придумывать решение. Такое поведение заметила автор проекта worklore Валентина Конюхова: в её эксперименте Codex и Kimi K3.1 пропускали поиск, которым пользовались при англоязычных заданиях.

Подробности и методику она опубликовала на Хабре.

Автор провела 1350 прогонов: шесть задач, девять конфигураций агентов, задания на русском и английском (с подсказками и без них). У всех был доступ в интернет.

На одной задаче Codex с низким уровнем рассуждений нашёл нужный формат на форуме и справился во всех пяти англоязычных прогонах.


С русским заданием он ни разу не обратился в Сеть и получил ноль успешных решений. У Kimi K3.1 похожий провал произошёл на задаче с OAuth.

Зато заметка с нужным фактом возвращала результат до пяти успешных результатов из пяти. В среднем подсказки повышали успешность на 33 процентных пункта для английских заданий и на 39 — для русских. Язык самой заметки почти ничего не менял.


Стоит учитывать, что задач в примере было всего шесть, повторов немного, а причину изменения поведения автор не проверяла. Но на всякий случай смотрите в логи, искал ли агент ответ.

RSS: Новости на портале Anti-Malware.ru