



Фишинговые сайты теперь детектируют виртуальные машины через JavaScript

Фишинговые сайты теперь детектируют виртуальные машины через JavaScript

Фишинговые сайты теперь детектируют виртуальные машины через JavaScript

Владельцы фишинговых сайтов теперь используют JavaScript для детектирования виртуальных машин и «безголовых устройств» (используются без монитора, клавиатуры и мыши), с помощью которых специалисты в области кибербезопасности вычисляют подобные вредоносные ресурсы.

Если один из таких фишинговых сайтов обнаружит признаки анализа со стороны исследователей, он отобразит пустую веб-страницу. Если же на ресурс попадёт жертва, то она увидит уже полноценный контент.

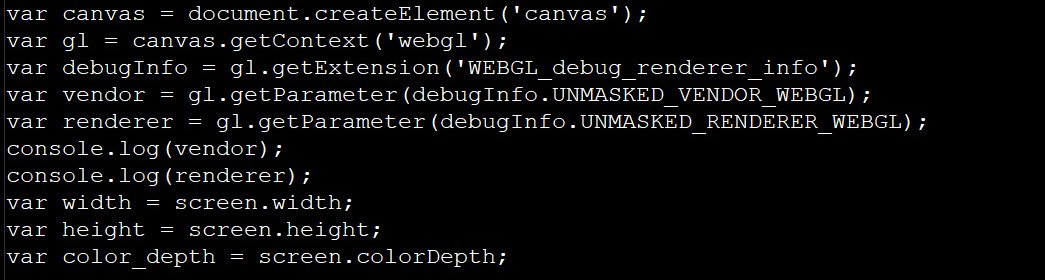
Хитрый скрипт, отвечающий за детектирование виртуальных машин, обнаружила команда MalwareHunterTeam. По словам экспертов, этот JavaScript-код проверяет ширину и высоту дисплея устройства посетителя, а также использует API WebGL для обращения к движку браузера.


Первым делом скрипт определяет, используются ли такие рендеры, как SwiftShader, LLVMpipe или VirtualBox. Именно они, как правило, выдают виртуальную машину. Помимо этого, JavaScript проверяет глубину цвета дисплея устройства.

Если фишинговый сайт «заподозрит» неладное, он выведет сообщение в консоль браузера и отобразит пустую страницу. Обычный же пользователь увидит контент, замаскированный под легитимный сайт.

Интересно, что фишеры воспользовались информацией, опубликованной в статье 2019 года. В ней специалисты описывали метод использования JavaScript для детектирования виртуальных машин.

Подпишитесь на новости

1,8 ТБ и вагон ошибок: как выгрузка с Яндекс Диска превратилась в квест

Пользователь «Яндекс Диска» решил сделать резервную копию 1,8 ТБ файлов, а также примерно 160 ГБ фотографий и получил приключение с ошибками API, зависшими загрузками и собственными скриптами.

По его словам, после октябрьских проблем с дата-центрами привычное скачивание папок через веб-интерфейс стало недоступно.

Подробности инженер Сергей Терёхин, известный как KenGuru66, описал  в собственном разборе на Хабре.

План был такой: rclone, сервер в Нидерландах, копия в Google Drive. Но стандартная аутентификация позволяла получить сведения о диске, а обращения к файлам возвращали ошибку 410. Доступ удалось наладить с другим OAuth-токеном.

Фотографии из безлимитной автозагрузки добавили веселья: для копирования через выбранный API их пришлось переместить в обычную папку. После этого они начали занимать место в тарифе. Более 30 тысяч снимков переносились около шести часов.

В выборке из 300 случайных файлов автор смог получить начало только 146. По важной папке с документами он скопировал и проверил по MD5 2315 файлов; ещё 3079 на момент публикации оставались недоступны.

Потерю данных автор не утверждает, он продолжает повторные загрузки. Скрипты опубликованы на GitHub.

RSS: Новости на портале Anti-Malware.ru