



Фишеры используют азбуку Морзе для маскировки URL на своей странице

Фишеры используют азбуку Морзе для маскировки URL на своей странице

Фишеры используют азбуку Морзе для маскировки URL на своей странице

Для обхода защитных почтовых шлюзов и фильтров авторы адресных фишинговых писем используют новаторский способ сокрытия вредоносного содержимого страницы. Теги JavaScript, внедряемые в HTML-код, шифруются с использованием азбуки Морзе.

Новая фишинговая компания стартовала, по всей видимости, в начале текущего месяца. Первые образцы мошеннических вложений были загружены на VirusTotal 2 февраля.

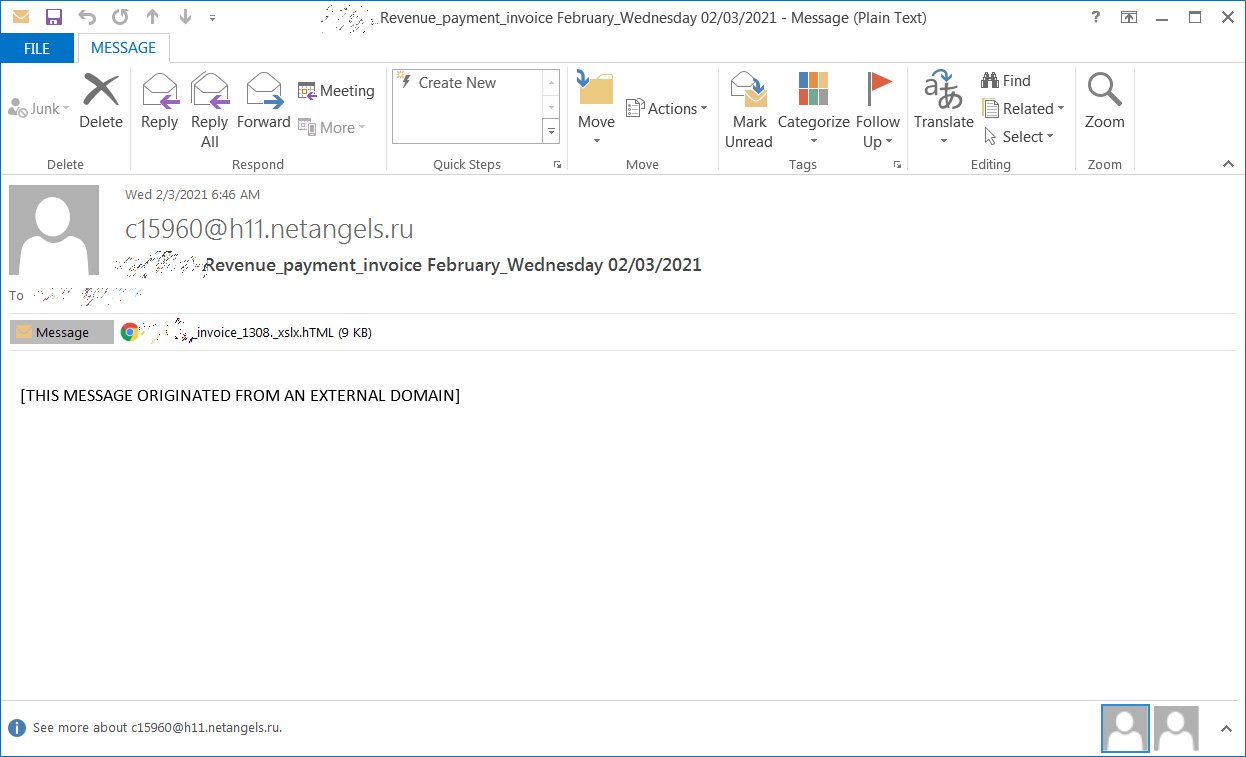
Поддельные сообщения замаскированы под требование оплаты услуг от имени некой организации. Прикрепленный файл, судя по названию, содержит счет-фактуру, выписанный на имя получателя письма, однако двойное расширение — ._xlsx.hTML — должно сразу насторожить адресата.


При просмотре вложения в текстовом редакторе эксперты обнаружили JavaScript, сопоставляющий буквы и цифры с символами азбуки Морзе. Этот сценарий расшифровывает код «морзянки», вызывая функцию decodeMorse(). На выходе получается шестнадцатеричная строка, декодирование которой выявляет теги JavaScript, подставляемые в HTML-код страницы.

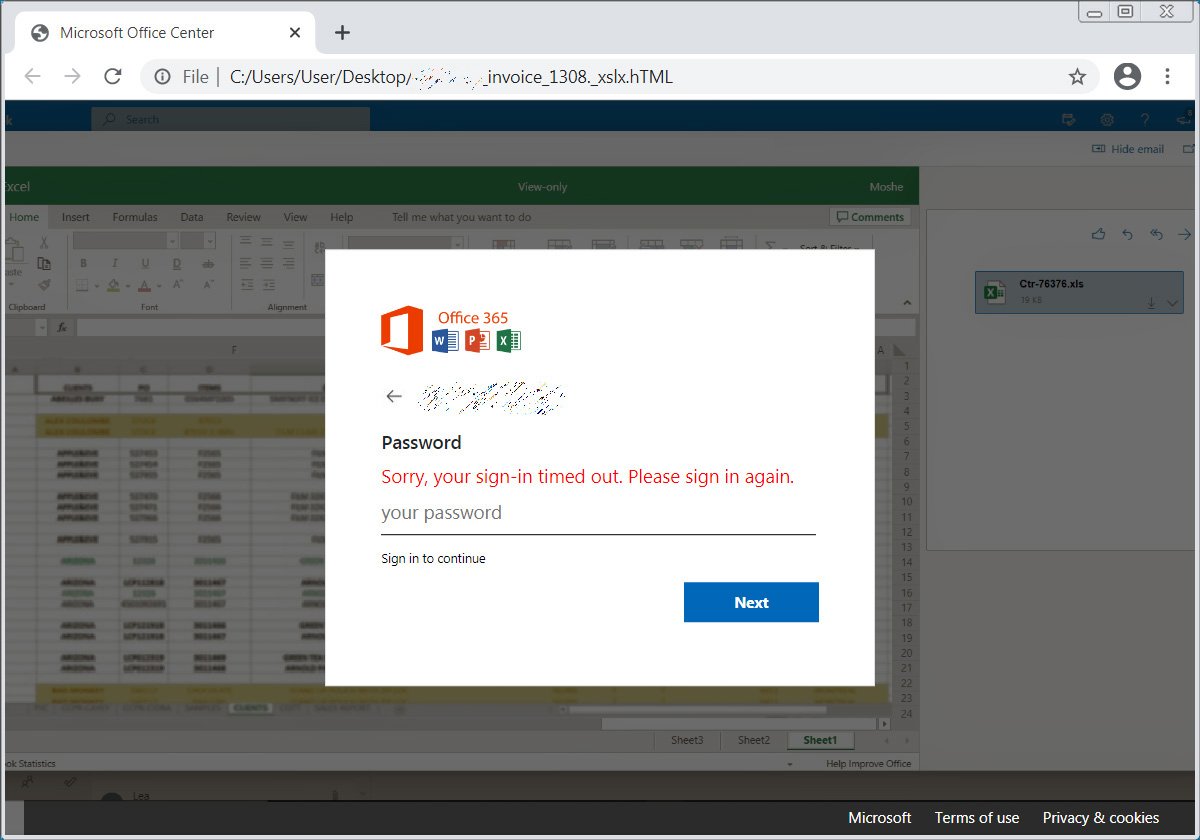
Внедрение скриптов в данном случае обеспечивает ресурсы, необходимые для рендеринга поддельной таблицы Excel с диалоговым окном — пользователю сообщается, что время авторизации истекло и нужно повторно ввести пароль. Если жертва последует этому указанию, данные из формы отправятся на сервер злоумышленников.

Для пущей убедительности фишинговая страница снабжена логотипом атакуемой компании — мошенники получают его с сайта logo.clearbit.comservice. Если требуемого значка там нет, они используют логотип Office 365.


Исследователям из BleepingComputer пока удалось выявить 11 мишеней текущей фишинговой кампании: SGS, Dimensional, Metrohm, SBI Mauritius Ltd (подразделение Государственного банка Индии), NUOVO IMAIE, Bridgestone, Cargeas, ODDO BHF Asset Management, Dea Capital, Equinti и Capital Four.

Подпишитесь на новости

1,8 ТБ и вагон ошибок: как выгрузка с Яндекс Диска превратилась в квест

Пользователь «Яндекс Диска» решил сделать резервную копию 1,8 ТБ файлов, а также примерно 160 ГБ фотографий и получил приключение с ошибками API, зависшими загрузками и собственными скриптами.

По его словам, после октябрьских проблем с дата-центрами привычное скачивание папок через веб-интерфейс стало недоступно.

Подробности инженер Сергей Терёхин, известный как KenGuru66, описал  в собственном разборе на Хабре.

План был такой: rclone, сервер в Нидерландах, копия в Google Drive. Но стандартная аутентификация позволяла получить сведения о диске, а обращения к файлам возвращали ошибку 410. Доступ удалось наладить с другим OAuth-токеном.

Фотографии из безлимитной автозагрузки добавили веселья: для копирования через выбранный API их пришлось переместить в обычную папку. После этого они начали занимать место в тарифе. Более 30 тысяч снимков переносились около шести часов.

В выборке из 300 случайных файлов автор смог получить начало только 146. По важной папке с документами он скопировал и проверил по MD5 2315 файлов; ещё 3079 на момент публикации оставались недоступны.

Потерю данных автор не утверждает, он продолжает повторные загрузки. Скрипты опубликованы на GitHub.

RSS: Новости на портале Anti-Malware.ru