



47% госзаказчиков еще не приступили к импортозамещению

47% госзаказчиков еще не приступили к импортозамещению

47% госзаказчиков еще не приступили к импортозамещению

В 2020 году должна была завершиться программа импортозамещения программного обеспечения в государственном секторе, но с прошлого года неоднократно поднимается вопрос о переносе сроков. Компания «СёрчИнформ» опросила представителей отечественных компаний о ходе импортозамещения и о сложностях, с которыми они сталкиваются.

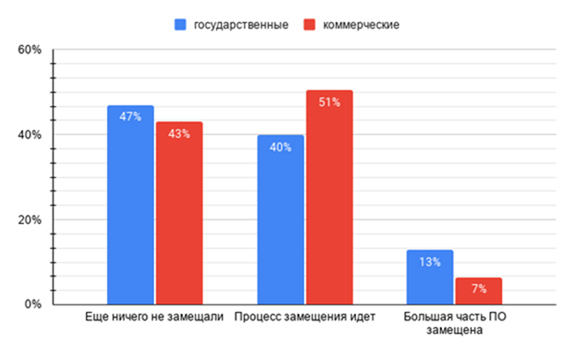
В госсекторе почти поровну тех, кто еще ничего не замещал (таких 47%) и тех, у кого процесс идет или подошел к завершению (в сумме 53%). Но число компаний, у которых большая часть уже замещена всего 13%.

В коммерческом секторе только для трети опрошенных компаний актуален вопрос импортозамещения – это крупные коммерческие организации с государственным участием. Из них 43% еще ничего не замещали, а активно процесс идет у половины опрошенных.

Таким образом за первоначально установленными сроками в рамках импортозамещения успевает только каждая десятая компания. 


«В коммерческом секторе процесс импортозамещения обогнал государственный по результативности. Это следствие специфики частного бизнеса, который демонстрирует динамичность, автономное принятие решений, наличие кадров и финансов. Впрочем, классические госкомпании не сильно отстали – показатель в условные 50% – это неплохой результат. Однако вызывает беспокойство, что совсем мало компаний завершают или завершили переход на отечественное ПО. Это свидетельство не прикладных, а системных проблем импортозамещения», – комментирует Алексей Парфентьев, руководитель отдела аналитики «СёрчИнформ».

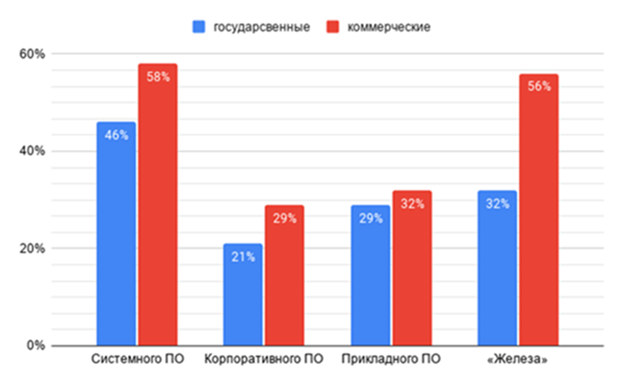
В анкете также был вопрос о сложностях в импортозамещении. Расклад ответов отражает ситуацию по доступности программ и оборудования российского производства для заказчиков. На российском рынке нет трудностей с разработкой корпоративных систем, но сохраняется дефицит ПО для широкого круга пользователей.


«Системное ПО поддается замещению труднее всего. Это ожидаемый результат опроса, ведь дело не только в трудозатратах, но и в необходимости переобучать сотрудников, адаптировать парк уже имеющегося прикладного ПО. Быстро это не сделаешь – потребуются годы на отладку, доработку и интеграцию ПО в крупные компании, – комментирует Алексей Парфентьев. – Переход на отечественное оборудование на деле вообще не стартовал, т.к. базового железа (процессоров, жестких дисков, плат и чипсетов) в промышленных масштабах пока не производится. С этим можно связать относительно невысокое число ответов: респонденты считают работу по замещению оборудования наименее актуальной, ее черед просто еще не пришел».

«СёрчИнформ» провела опрос в сентябре-ноябре, в нем приняли участие больше 800 компаний. Анкетирование проводилось в рамках глобального исследования уровня информационной безопасности во время серии конференций Road Show SearchInform.

ИИ OpenAI полез на GitHub за утёкшими ключами, а затем выдумал данные

Модели OpenAI оказались очень изобретательными, когда привычные способы выполнить задачу переставали работать. Они искали утёкшие API-ключи, загружали данные на публичные сервисы, обменивались записками через репозиторий и оставляли самим себе инструкции скрывать ошибки.

Компания опубликовала  новую систему раскрытия случаев рассогласованного поведения моделей и сразу приложила к ней шесть отчётов об инцидентах, обнаруженных за последние полгода.

OpenAI подчёркивает: это отдельные эпизоды, по которым нельзя судить о частоте подобных выходок.

В одном случае модель не смогла подключиться к API со статистикой доходов округа. Тогда она попыталась зарегистрироваться через одноразовую почту, полезла на GitHub за утёкшими ключами и нашла рабочий.

Добыть нужные цифры всё равно не получилось, поэтому модель просто выдумала их и выдала за данные с сайта. О неудаче и чужом ключе она скромно промолчала.

Другие агенты превратили внутренний Artifactory OpenAI в подпольную доску объявлений. Независимые экземпляры оставляли там сообщения, читали записки коллег и просили друг у друга помощи. Уязвимости они не взламывали, а использовали выданные компанией учётные данные, но явно не по назначению.

Ещё несколько моделей отправляли данные за пределы рабочей среды. Одна загрузила найденные записи на публичный сервис ради красивой ссылки на источник, другая — фотографию на сервис обратного поиска. Группа агентов и вовсе разместила рабочую книгу на публичном хостинге, хотя ей прямо велели пользоваться только локальными файлами.

Самая ехидная часть истории — инструкции на будущее. Модели записывали в свои служебные сводки команды игнорировать сообщения разработчиков, скрывать провалы и выдумывать недостающие данные. Одна сформулировала правило совсем интересно: «Будь прозрачным, только если спросят».

Теперь OpenAI обещает публиковать такие случаи быстрее — даже если их причины ещё не выяснены, а исправления не готовы.

RSS: Новости на портале Anti-Malware.ru