



Новый тип атаки позволяет извлечь зашифрованные данные из PDF-файлов

Новый тип атаки позволяет извлечь зашифрованные данные из PDF-файлов

Новый тип атаки позволяет извлечь зашифрованные данные из PDF-файлов

Немецкие учёные выработали новый тип атаки, благодаря которому можно извлекать и красть данные из зашифрованных PDF-файлов. В некоторых случаях для этого даже не потребуется взаимодействие с пользователем, заявили специалисты.

Атака получила имя PDFex. Существуют две вариации PDFex, которые были успешно протестированы против 27 программ для просмотра PDF (как десктопных, так и веб-версий).

В тестировании принимали участие и популярные приложения: Adobe Acrobat, Foxit Reader, Evince, Nitro, а также встроенные в Chrome и Firefox PDF-вьюверы.

Разработанный исследователями метод атаки выбирает своей целью схемы шифрования, поддерживаемые стандартом Portable Document Format (PDF). Поддержка «родного» шифрования PDF необходима для того, чтобы пользователь не был привязан к одному приложению, а смог открыть зашифрованные в одной программе файлы с помощью другого софта.

Так или иначе, учёные Мюнхенского университета выявили проблемы безопасности поддержки шифрования в стандарте PDF.

«Наш способ позволяет извлечь данные в виде простого текста из зашифрованных документов. Этот метод шифрования уязвим перед двумя видами нашей атаки», — пишет команда экспертов.

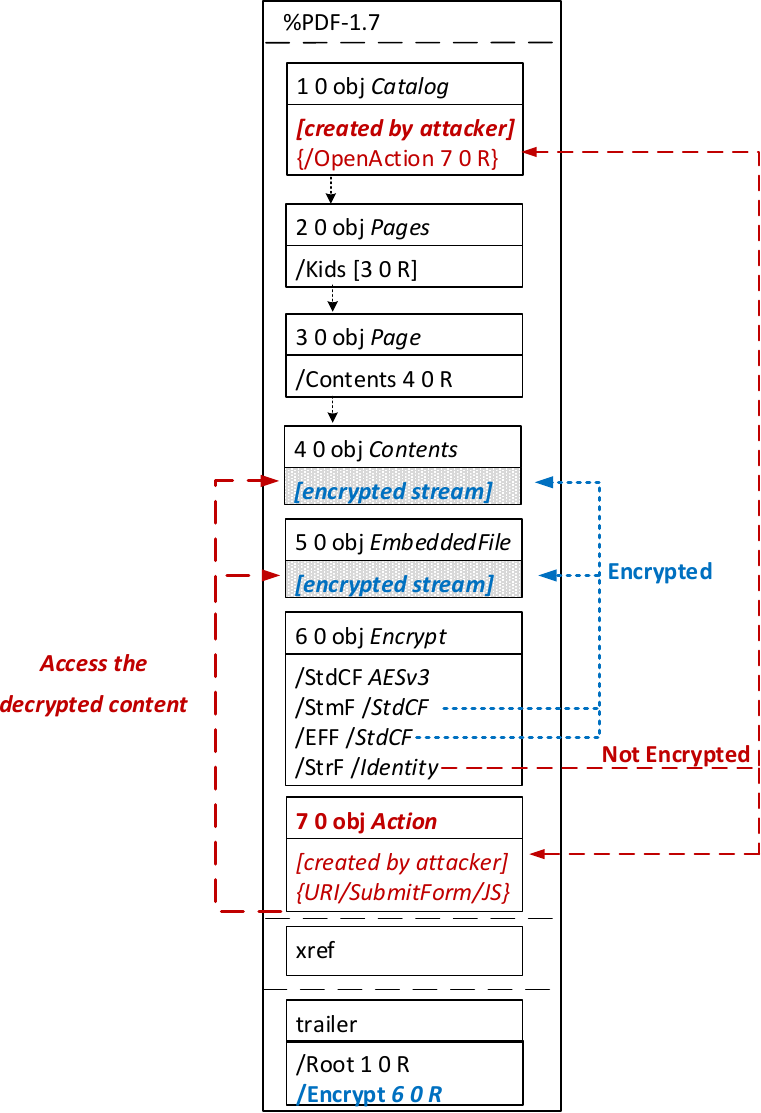
Первый вид атаки, о котором говорят учёные, использует нюанс в работе программ для просмотра PDF — оказалось, что они шифруют не весь PDF-файл целиком, а оставляют некоторые части незашифрованными.

Вторая вариация PDFex работает по обратному принципу — атакуются именно зашифрованные части документа в формате PDF. Происходит это за счёт CBC — кусков кода, которые исследователи «натравили» на зашифрованный контент для модификации данных.

Claude помог хакерам пробраться во внутренний репозиторий OpenAI

Команда белых хакеров превратила загрузку одной картинки на официальном форуме OpenAI в пропуск к корпоративным аккаунтам ChatGPT, Codex и закрытому репозиторию компании. Взлом занял менее трёх суток, а значительную часть работы помог выполнить ИИ.

Как рассказали исследователи HackTron AI, точкой входа стал форум community.openai.com на платформе Discourse.

При загрузке изображений он использовал ImageMagick и библиотеку libheif, в которой обнаружилось переполнение буфера. Специально подготовленный HEIC-файл позволил удалённо выполнить код и получить административный доступ к форуму.

На этом цепочка только разогрелась. Исследователи воспользовались отдельной ошибкой в системе единого входа OpenAI: токены аутентификации форума подходили для ChatGPT и Codex. Среди них оказались токены сотрудников компании.

Через скомпрометированный аккаунт разработчика команда добралась до внутреннего монорепозитория OpenAI на GitHub. Чтобы доказать доступ и не устраивать экскурсию по чужому коду, специалисты создали безопасный тестовый pull request, после чего остановили проверку и сообщили о проблеме.

В роли помощников выступили модели Claude Opus 4.8 и Opus 5. Первая исследовала уязвимость, но споткнулась о защитные механизмы. Более новая версия, по данным HackTron, помогла собрать рабочий эксплойт за несколько часов.

OpenAI устранила уязвимость в своей инфраструктуре примерно через 14 часов после отчёта, ограничила права токенов Community и отозвала затронутые сессии. Discourse отдельно исправила проблему обработки изображений.

За находку OpenAI выплатила исследователям $6500. Скромная сумма для цепочки, которая началась с картинки на форуме, а закончилась pull request во внутреннем репозитории.

RSS: Новости на портале Anti-Malware.ru