



Контейнерные среды усложняют мониторинг: атака может пройти путь от уязвимого приложения до хоста и Kubernetes за минуты, а сам контейнер — исчезнуть. Разбираемся в том, какую телеметрию собирает EDR, как выявлять мисконфигурации и уязвимости и где нужны другие средства защиты.
- 1. Введение
- 2. Как злоумышленник попадает внутрь
- 3. От контейнера к контролю над кластером
- 4. Что меняет EDR: контекст вместо разрозненных событий
- 5. Обнаружение: даже если контейнера уже нет
- 6. Почему в Linux нет единого источника телеметрии
- 7. Цена видимости: как удержать нагрузку под контролем
- 8. Реагирование и превентивный контроль
- 9. Как выявляют уязвимости в контейнерах
- 10. Выводы
Введение
Контейнеры и микросервисная архитектура из перспективных технологий превратились в стандарт корпоративной разработки. Но для команд кибербезопасности контейнерная среда остаётся одной из самых неудобных зон мониторинга. Атака здесь может развиться за минуты — от компрометации образа до побега из контейнера и доступа к оркестратору. А короткоживущий контейнер исчезнет вместе со всеми следами раньше, чем SOC успеет обратить на него внимание.
Разберём, как устроены атаки на контейнеры, почему привычные средства защиты здесь теряют видимость и что делает EDR. Отдельно посмотрим, чем поиск уязвимостей в контейнерах отличается от работы с обычными серверами и какие ещё инструменты закрывают контейнерную безопасность.
Как злоумышленник попадает внутрь
Точка входа в контейнер — это чаще всего одна из трёх дверей.
Первая — уязвимость в самом приложении. Если сервис принимает внешние запросы и содержит уязвимость типа RCE (remote code execution, удалённое выполнение кода), атакующий отправляет специально сформированный запрос и получает командную строку внутри контейнера, не имея вообще никаких учётных данных.
Вторая — скомпрометированный образ. Приложение упаковывают поверх готового базового образа из публичного или корпоративного реестра, а тот тянет за собой десятки системных пакетов и библиотек. Уязвимость в одной библиотеке, вредоносный пакет с названием, напоминающим легитимное, в публичном репозитории, давно не обновлявшийся образ в корпоративном реестре — все эти сценарии превращают образ в точку входа ещё до того, как контейнер запущен.
Третья — утекшие учётные данные. Токен с доступом к кластеру, случайно попавший в публичный репозиторий или перехваченный через фишинг, открывает доступ напрямую, минуя контейнер целиком.
После проникновения злоумышленник начинает с разведки. Первым делом он читает переменные окружения. Пароли к базам данных, токены и API-ключи чаще всего передаются в контейнер именно через них, а не через защищённое хранилище секретов. Дальше атакующий смотрит, какие сервисы доступны изнутри и что смонтировано в файловую систему. Если приложение запущено от root — распространённая ошибка при сборке образа, — повышать привилегии не приходится вовсе.
Проблему могут усугубить типовые ошибки настройки Linux-хостов, на которых работает контейнерная инфраструктура. По данным BI.ZONE SOC, в 73% компаний разрешён запуск опасных утилит через sudo, а в 88% возможен SSH-доступ по паролю, включая root. Такая почва превращает даже ограниченный доступ внутри контейнера в трамплин для дальнейшего продвижения.
От контейнера к контролю над кластером
Следующий шаг — побег из контейнера. Изоляция здесь не абсолютна: все контейнеры работают на одном ядре ОС, и уязвимость в ядре или в самой среде запуска стирает границу между изолированной средой и хостом. Но чаще побег происходит не через эксплойт, а через мисконфигурацию. Контейнер с избыточными привилегиями или с примонтированными системными путями хоста получает прямой доступ к его файловой системе и устройствам. Частный, но очень распространённый случай — проброшенный внутрь контейнера сокет управления средой контейнеризации. Он отдаёт злоумышленнику контроль над всеми контейнерами на хосте.
Рисунок 1. Пример файла Docker Compose, запускающего контейнер с небезопасной привилегией SYS_MODULE
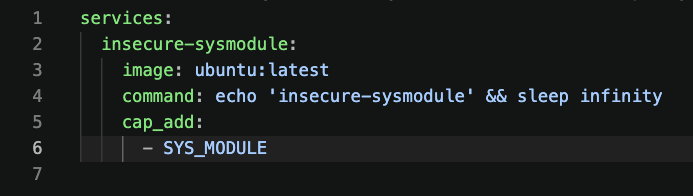
Рисунок 2. Пример файла Docker Compose, запускающего контейнер с примонтированным каталогом /etc хостовой системы
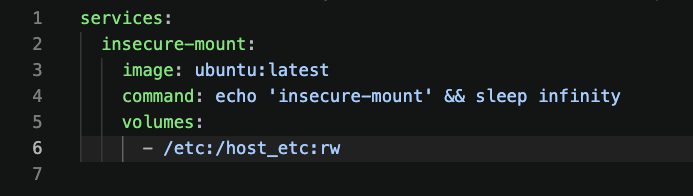
Рисунок 3. Запуск контейнеров с подобными уязвимостями в конфигурации отслеживается средствами BI.ZONE EDR
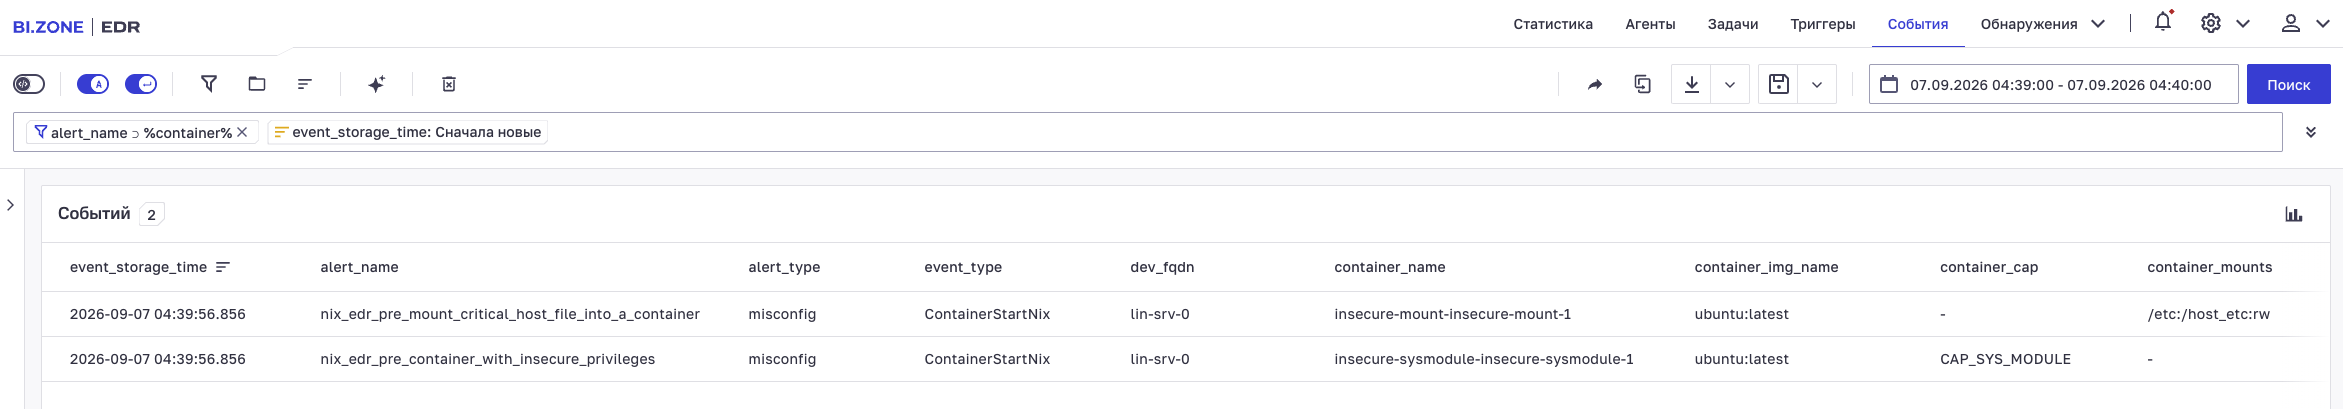
Именно мисконфигурации часто делают побег из контейнера возможным. Эксперты BI.ZONE SOC отмечают, что контейнеры с избыточными привилегиями и небезопасными точками монтирования встречаются у 60% организаций. То есть для большинства компаний побег из контейнера — это не теоретическая угроза, а вопрос времени.
Выйдя на хост, злоумышленник добирается до оркестратора. На каждом рабочем узле Kubernetes хранятся учётные данные для обращения к API кластера. Атакующий находит их и получает управление всей инфраструктурой. Дополнительный вектор — токены доступа, которые Kubernetes по умолчанию монтирует внутрь каждого пода. При небрежно настроенных правах такой токен даёт административные привилегии над кластером даже без выхода на хост.
Рисунок 4. BI.ZONE EDR обнаруживает попытки получения учётных данных сервисного аккаунта Pod
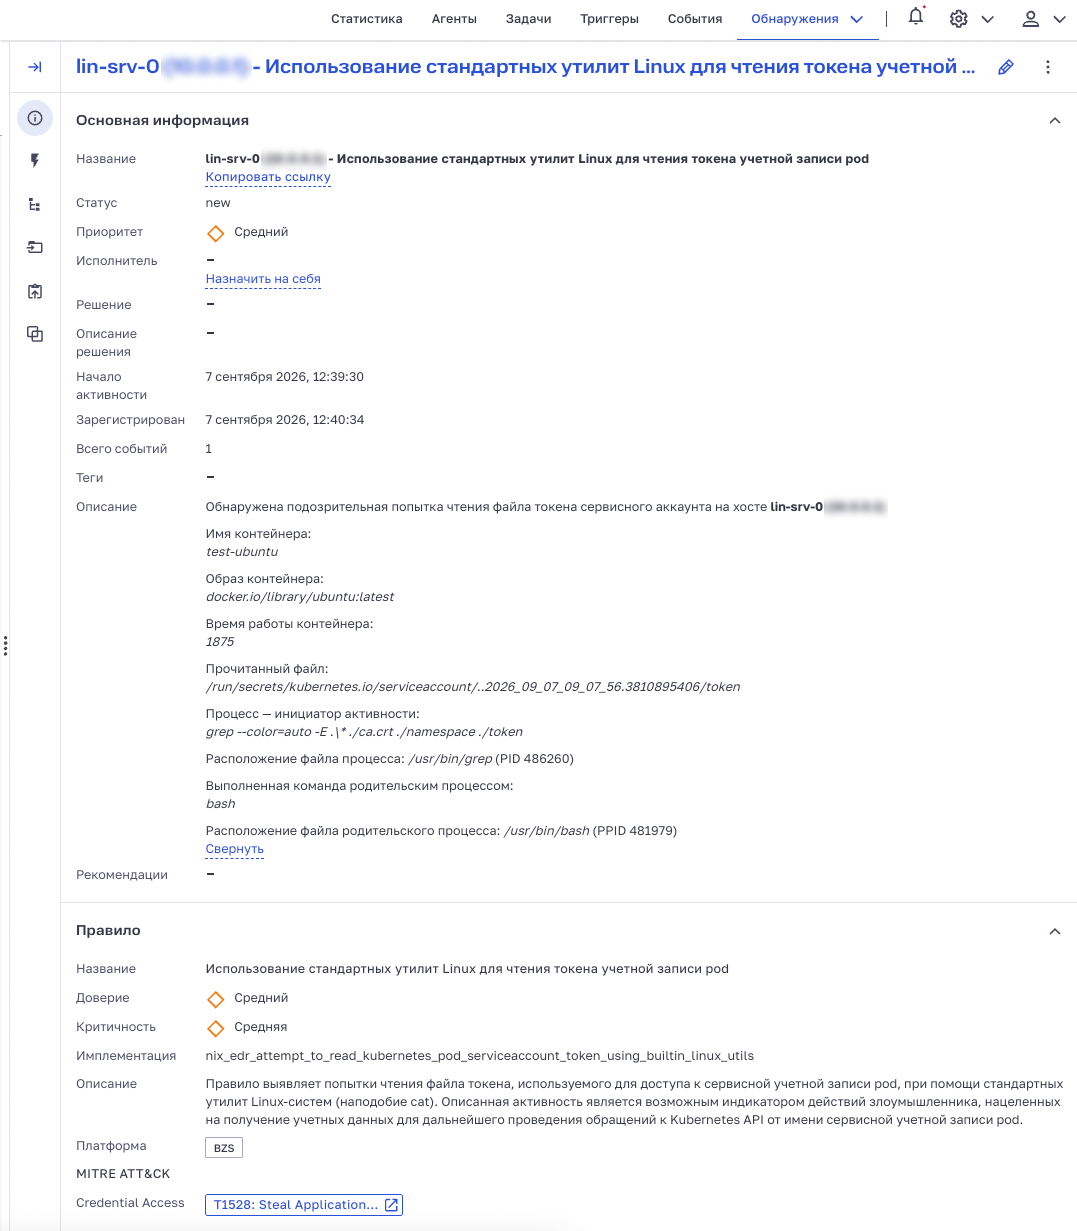
Рисунок 5. Пример файла конфигурации API-сервера Kubernetes с небезопасными значениями у нескольких параметров
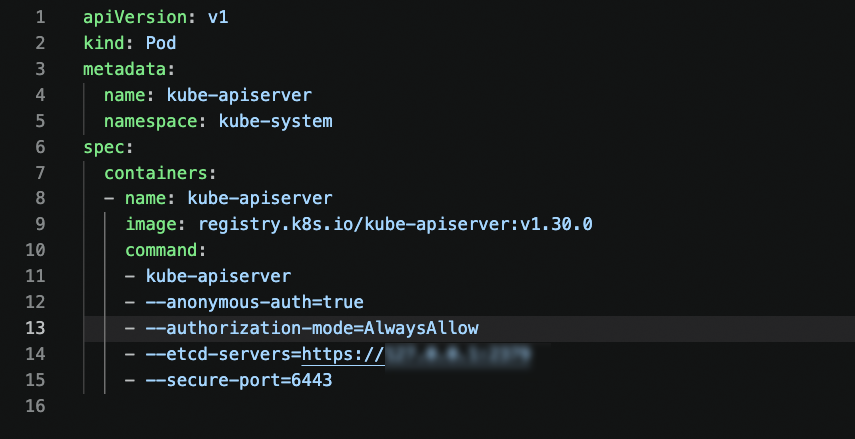
Рисунок 6. BI.ZONE EDR формирует оповещения об обнаруженных мисконфигурациях
С этого момента в распоряжении злоумышленника весь кластер: атакующий запускает свои процессы на любых узлах, читает все секреты, получает доступ к внутренним системам и базам данных, движется дальше в корпоративную сеть. И вся цепочка — от первого запроса до контроля над инфраструктурой — может уложиться в минуты.
Описанные шаги — это не абстрактный сценарий, а систематизированные техники из матрицы MITRE ATT&CK for Containers: побег из контейнера, повышение привилегий, злоупотребление Linux capabilities, запуск криптомайнеров и несанкционированных процессов. Отдельного внимания заслуживают сетевая активность контейнера, взаимодействие с API Kubernetes, обращения к образам и реестрам — именно там проявляются попытки закрепиться и расширить доступ.
Что меняет EDR: контекст вместо разрозненных событий
Скорость развития атаки и обилие мисконфигураций делают контейнерную инфраструктуру удобной мишенью, а мониторинг такой среды вызывает ряд сложностей. Первая — потеря контекста. Одно и то же событие может быть как нормальной операцией приложения, так и признаком компрометации — всё зависит от того, в каком контейнере, поде и с какими правами оно произошло.
EDR-решения с поддержкой контейнерных сред закрывают эту проблему привязкой каждого события к конкретному контейнеру и контексту оркестрации. Разберём фрагмент телеметрии с обычного веб-сервера.
Рисунок 7. Пример активности внутри контейнера, зафиксированной средствами BI.ZONE EDR
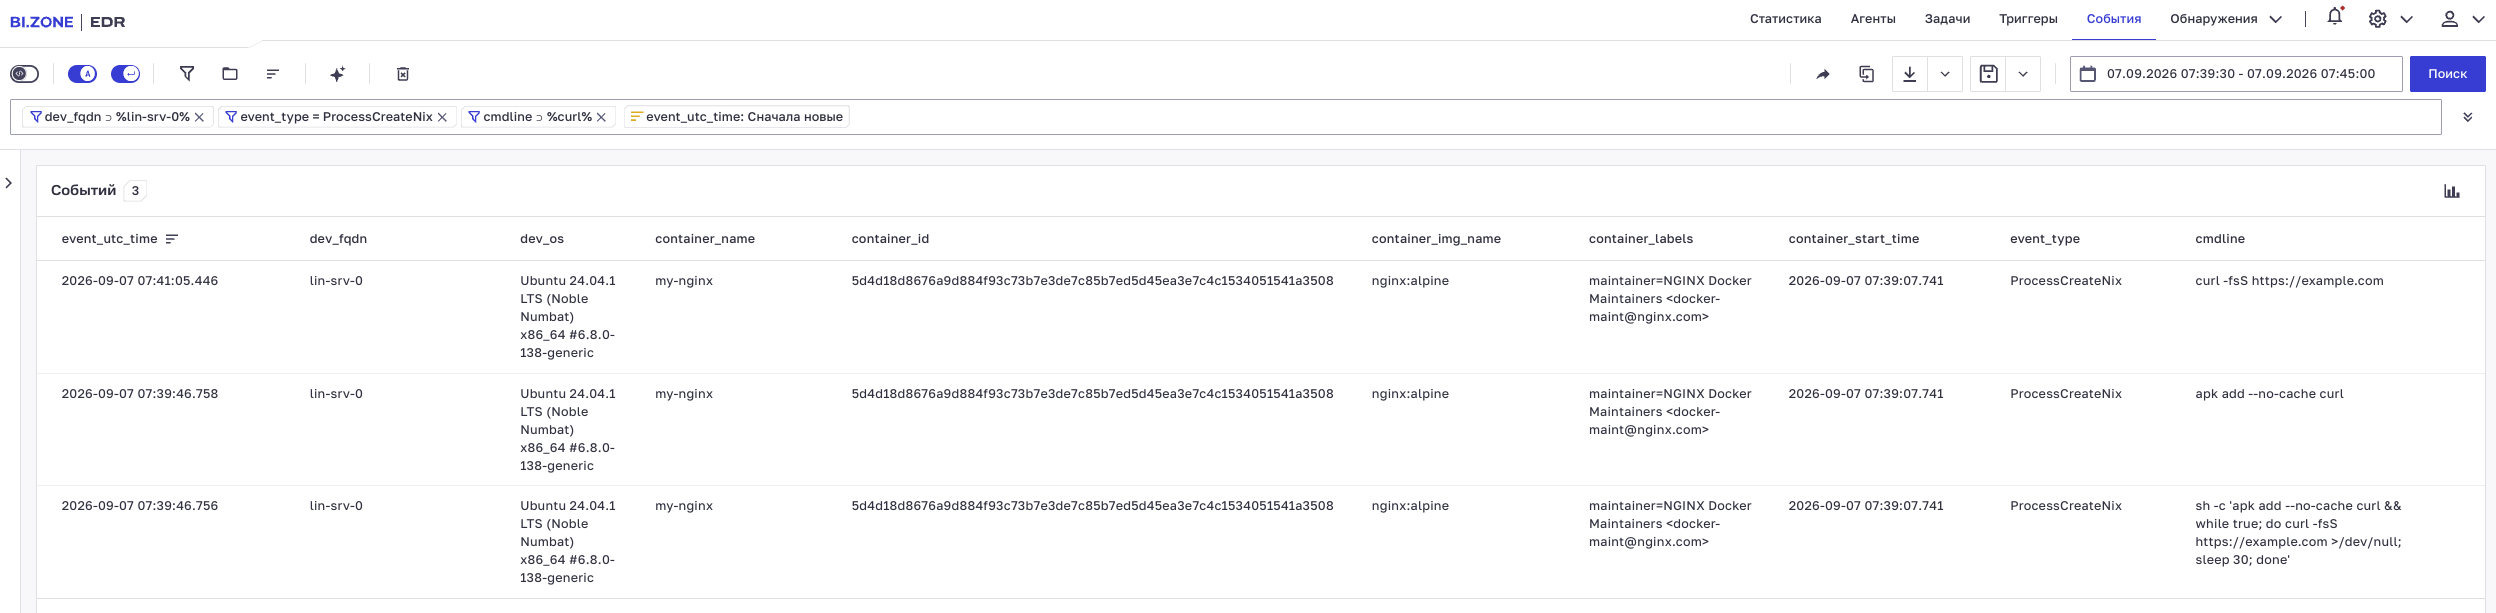
Три записи в пределах двух минут. Сначала внутри работающего контейнера запускается установка curl, которого в исходном образе не было. Следом стартует бесконечный цикл с обращением к внешнему адресу каждые 30 секунд. Контейнер не должен меняться после запуска, поэтому установка нового пакета в работающем экземпляре — уже аномалия. Периодические обращения наружу после неё усиливают подозрение.
В одной записи есть всё, что нужно для разбора. Видно имя контейнера и образ, из которого он развёрнут, полную командную строку запущенного процесса, версию ОС и ядра хоста, движок контейнеризации, тип события и источник телеметрии, через который оно получено. Без этих полей в журнале осталась бы строка «Запущен процесс curl» без указания, где именно. И отличить действия злоумышленника от рутинной работы администратора было бы невозможно.
Такой уровень детализации позволяет сразу определить источник подозрительной активности и понять, как она соотносится с логикой приложения. Для одного пода исходящий сетевой запрос является штатной операцией, для другого — признаком компрометации.
Параллельно EDR-решение делает динамичную среду наблюдаемой. Оно выполняет периодическую инвентаризацию контейнеров, отслеживает запущенные и остановленные экземпляры, фиксирует операции с ними, включая добавление, удаление, запуск и остановку. Внутри контейнеров контролируются запуск процессов и файловые операции.
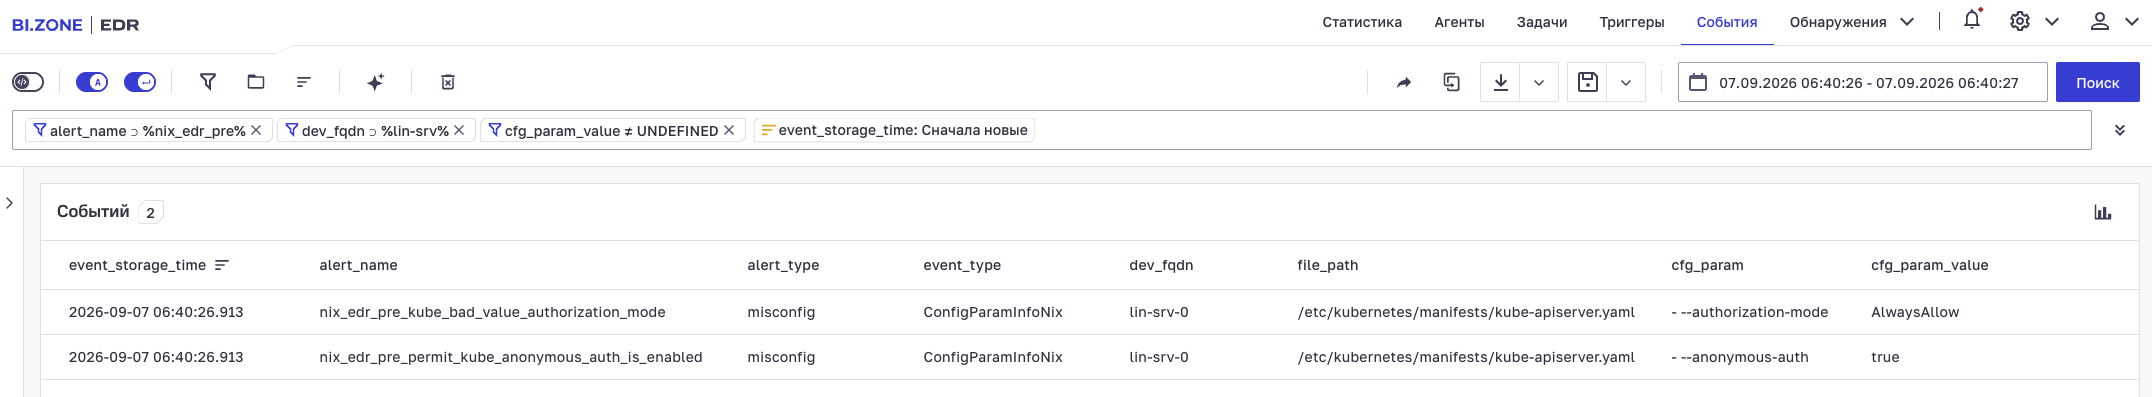
Отдельный слой — аудит конфигурации самого оркестратора. Настройки компонентов Kubernetes хранятся в манифестах на узлах кластера и передаются параметрами запуска процессов. Поэтому решение читает их напрямую с хостов управляющего слоя и рабочих узлов, а затем сверяет с рекомендуемыми практиками. Проверки закрывают типовые слабые места. Разрешён ли анонимный доступ к API-серверу и к API kubelet, включён ли режим авторизации RBAC вместо разрешающего всё режима AlwaysAllow, настроены ли TLS-сертификаты и проверка клиентских сертификатов, включено ли логирование, какие admission-контроллеры включены и отключены, зашифрованы ли данные в etcd. И это не гипотетические проблемы.
По информации BI.ZONE SOC, на 33% кластеров не отключена возможность анонимного доступа к API-серверу, на 33% отсутствует шифрование данных в etcd на уровне API-сервера, на 31% не выполняется проверка сертификатов kubelet со стороны Kubernetes API. Каждая из этих настроек становится готовой точкой входа, и выявляют их до того, как ими воспользуются.
Рисунки 8 и 9. Так выглядит результат одной из проверок
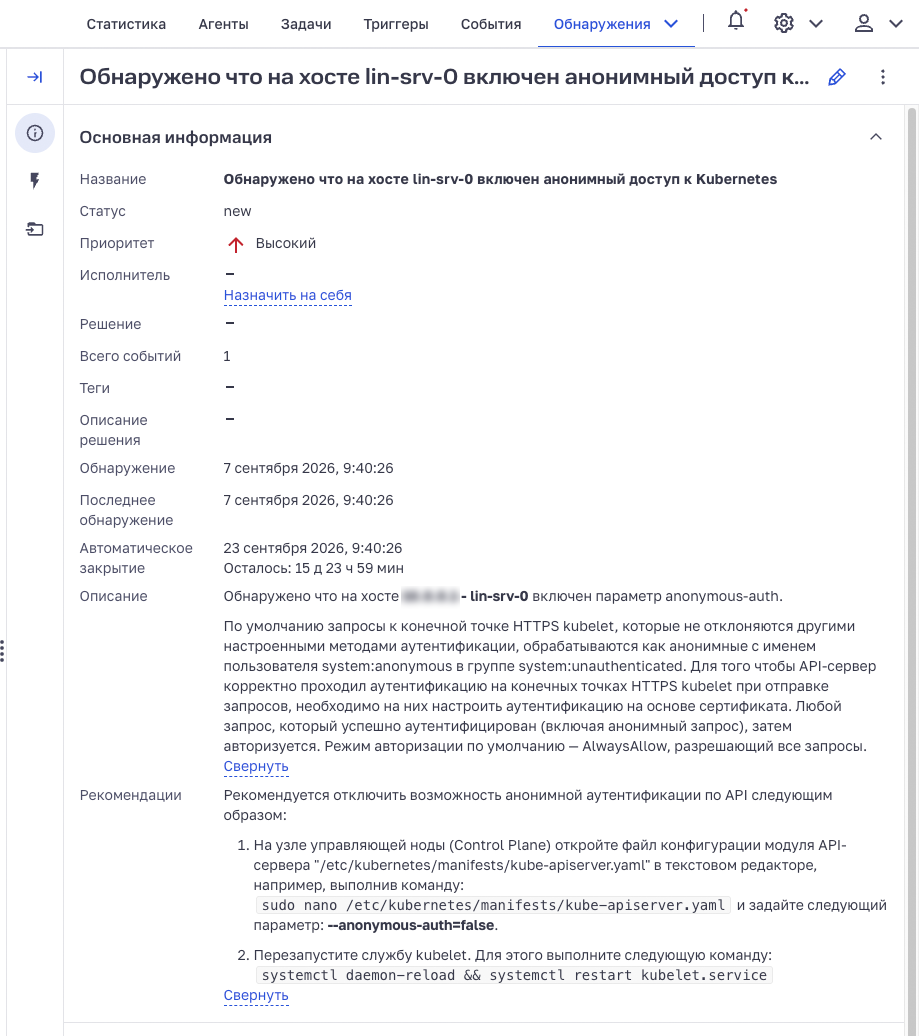
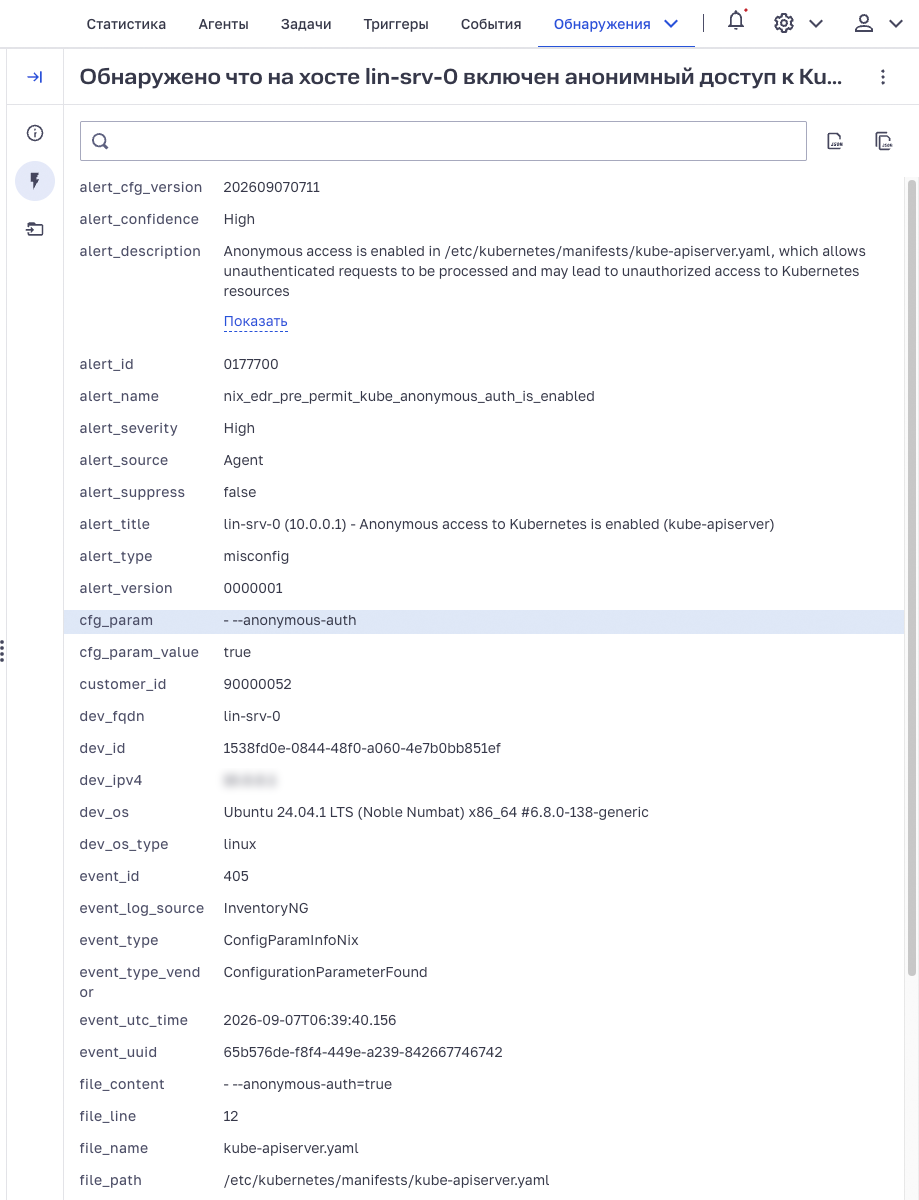
Рисунок 10. BI.ZONE EDR предоставляет подробный контекст и рекомендации по устранению обнаруженных мисконфигураций
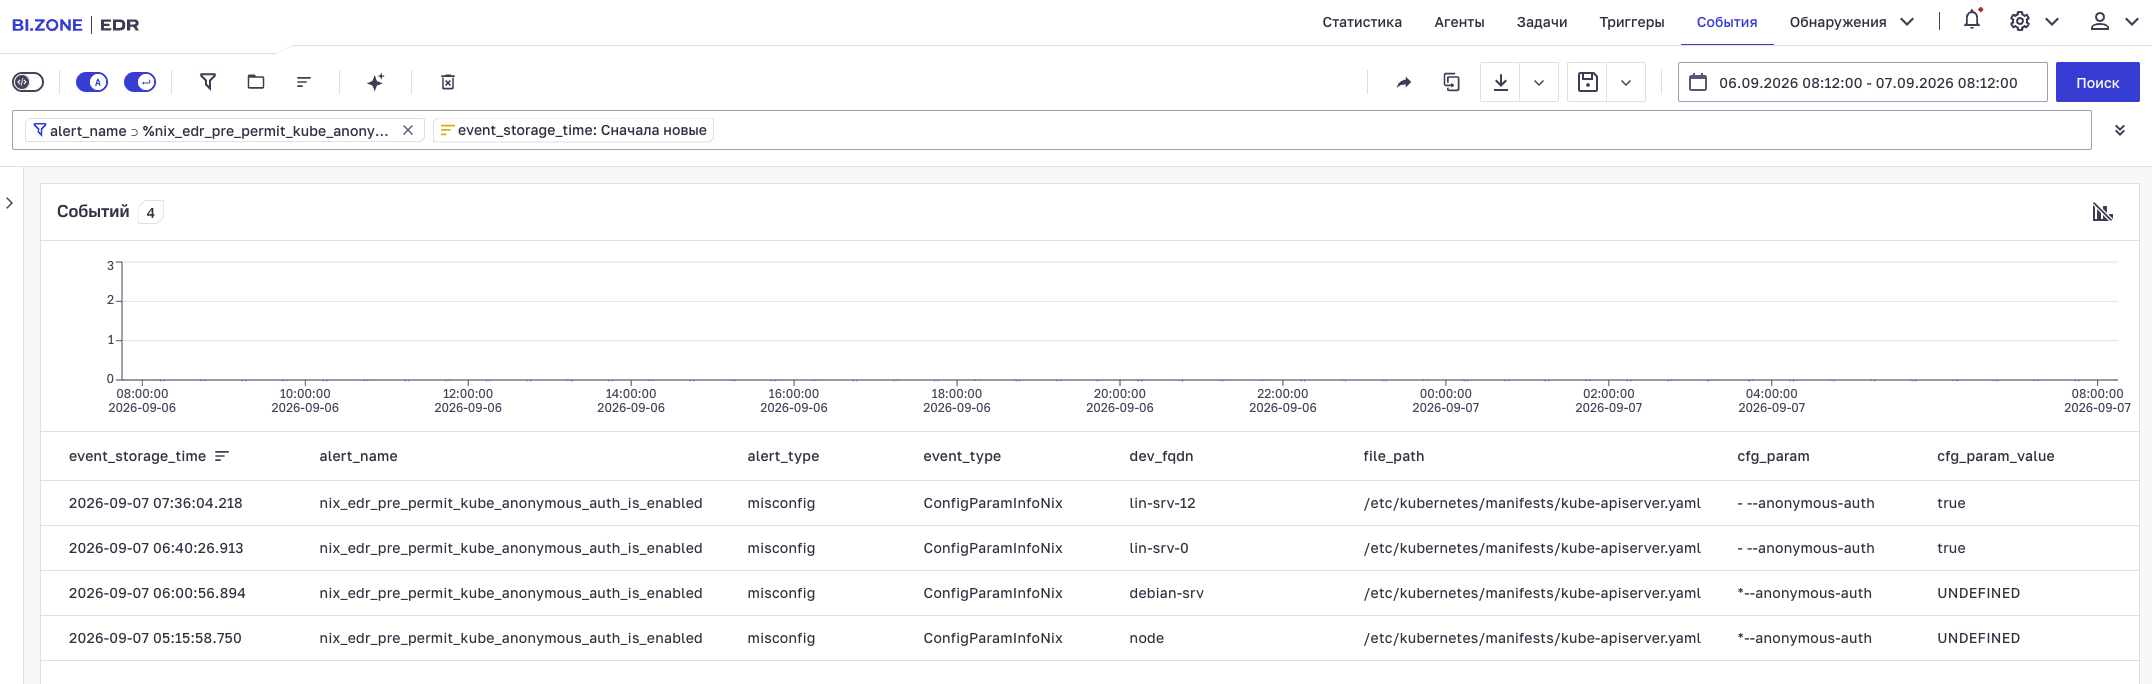
Решение прочитало манифест kube-apiserver на узле управляющего слоя и зафиксировало состояние параметра, отвечающего за анонимный доступ. В части случаев флагу явно задано небезопасное значение, в остальных не задан вовсе, поэтому действует значение по умолчанию, которое разрешает анонимные запросы. Администратор сразу видит, в каком файле и какой параметр менять. Разницы между отсутствующим флагом и флагом со значением True нет: обе строки означают открытый анонимный доступ.
Обнаружение: даже если контейнера уже нет
Централизованное хранение телеметрии решает одну из ключевых проблем контейнерных сред — их короткий жизненный цикл. Контейнер может исчезнуть за секунды, но собранные агентом события к этому моменту уже переданы на сервер EDR и хранятся там, независимо от судьбы самого контейнера. Записи о запуске процессов, файловых операциях и сетевых соединениях остаются доступными для ретроспективного анализа. Благодаря этому аналитик может полностью восстановить хронологию инцидента даже в контейнере, которого уже не существует, а также проводить threat hunting.
Чтобы выявлять атаки в потоке телеметрии, система использует несколько технологий одновременно: поведенческие корреляционные правила (IoA), индикаторы компрометации (IoC) и YARA-правила. Именно поведенческий анализ позволяет эффективно обнаруживать техники из матрицы MITRE ATT&CK for Containers — от попыток побега из контейнера до запуска криптомайнеров, а также бесфайловые атаки и злоупотребление легитимными инструментами, против которых традиционные сигнатуры бессильны.
Почему в Linux нет единого источника телеметрии
В корпоративных инфраструктурах контейнеры разворачивают преимущественно на Linux, и здесь сбор телеметрии устроен принципиально иначе, чем в Windows. В Windows сложился привычный набор штатных механизмов ядра и журналов, а поверх них — готовые инструменты вроде Sysmon, ставшие стандартом для индустрии мониторинга. В Linux механизма, покрывающего все задачи сразу, нет — есть набор механизмов ядра, у каждого из которых своя область применения и своя цена.
Самый универсальный — Linux Audit Framework (LAF). Это штатная подсистема аудита в ядре, знакомая многим по демону auditd, который читает её события и пишет в журнал. Главное достоинство LAF в том, что он есть практически везде, включая старые дистрибутивы, которые в корпоративных инфраструктурах живут годами. Платить за это приходится производительностью, так как аудит системных вызовов добавляет проверки в путь их выполнения, а формирование, передача и запись событий требуют дополнительных ресурсов.
Цена особенно заметна при большом числе правил и попытке собирать всё подряд: растёт нагрузка на CPU, объём журналов и дисковый ввод-вывод. Одно действие может порождать несколько записей, которые нужно объединить в событие и интерпретировать. Сам auditd прежде всего сохраняет эти записи. Готовую модель поведения процессов и прикладной контекст приходится строить поверх него. В контейнерной инфраструктуре дополнительно требуется связывать активность на хосте с конкретными контейнерами, подами и рабочими нагрузками при помощи сторонних или самописных инструментов.
Есть у LAF и другая особенность. Правила аудита задаются одним общесистемным списком, который применяют все, кто пользуется подсистемой: штатный сервис аудита, системы мониторинга, средства защиты. Он применяется целиком, поэтому любая переконфигурация аудита заменяет список на новый набор правил. Спровоцировать это может перезапуск штатного сервиса, работа системы управления конфигурацией или настройка аудита другим средством защиты. Правила EDR-агента при этом могут просто исчезнуть, и он перестанет получать нужные события. Поэтому зрелое решение отслеживает состояние своих правил и восстанавливает их, не мешая остальным потребителям аудита.
Альтернатива — eBPF, механизм запуска в ядре изолированных программ-обработчиков. Он даёт меньшие накладные расходы при большем объёме контекста в событии, а файловые операции внутри контейнеров отслеживает там, где через аудит это сделать сложно. Но работает eBPF не везде: нужна поддержка со стороны ядра, причём требуемая версия зависит от набора собираемых событий. Для регулярно обновляемого парка такой проблемы нет. Она возникает там, где остаются системы, которые невозможно или слишком рискованно обновлять. В крупных инфраструктурах такие есть всегда, и одним eBPF весь парк не покроешь.
Механизмов сбора в Linux существует больше, но на практике EDR-решения чаще всего опираются на несколько основных. Помимо LAF и eBPF, это:
- Kernel Probes (kprobes) — механизм перехвата вызовов внутренних функций ядра. Позволяет получать события там, где штатного аудита недостаточно. Требует привязки к внутреннему устройству ядра, которое меняется от версии к версии.
- BPF для сетевого трафика — анализ сетевой активности на уровне ядра с возможностью связать соединение с породившим его процессом.
Эти механизмы не заменяют друг друга, а дополняют, и на практике зрелое EDR-решение опирается на несколько сразу.
Цена видимости: как удержать нагрузку под контролем
Комбинация источников решает не только задачу покрытия, но и задачу нагрузки. Разные механизмы компенсируют слабости друг друга, а способ сбора подбирают под конкретный класс хостов, исходя из влияния на инфраструктуру, полноты и объёма получаемых событий. Там, где eBPF недоступен, работу берут на себя аудит и kprobes.
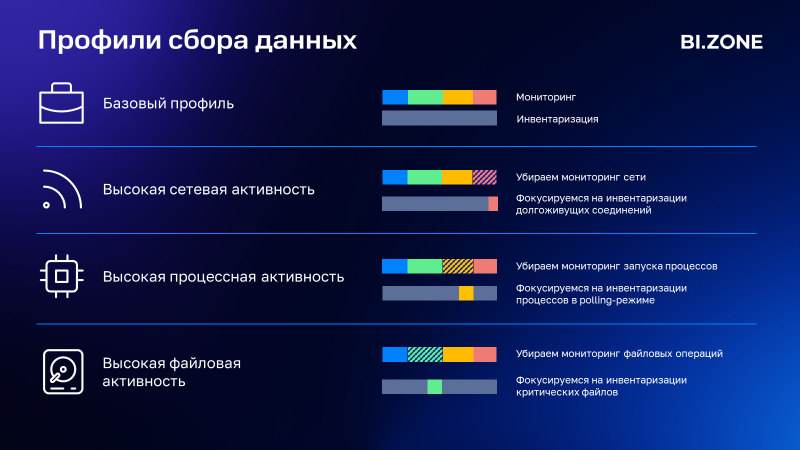
Тоньше настроить нагрузку позволяют профили сбора телеметрии — готовые наборы настроек под типовые сценарии эксплуатации. Если основную нагрузку создают файловые операции, в профиле отключается мониторинг файловой активности. Если проблема в лавине процессов, их регистрация переводится с непрерывного отслеживания на периодический опрос.
Система не обрабатывает каждый запуск в момент его возникновения, а с заданной периодичностью сверяется со списком уже работающих процессов. На полноту данных это влияет, и картина получается менее детальной. Потерю детализации компенсируют другие источники данных, поэтому способность выявлять угрозы сохраняется.
Для контейнерных сред настройка нагрузки особенно актуальна. Ноды кластеров и CI/CD-серверы изначально относятся к высоконагруженным системам, и в них заметен даже стандартный объём мониторинга. Именно для таких сценариев и существуют готовые профили. Поэтому развёртывание агента начинают не с установки по умолчанию, а с оценки характера эксплуатации.
Рисунок 11. Настройка профиля сбора телеметрии в BI.ZONE EDR
Реагирование и превентивный контроль
Обнаружить атаку — половина дела. Зрелое EDR-решение способно не только автоматически реагировать, но и эффективно помогать аналитику в его работе. Оно позволяет изолировать скомпрометированный хост от сети с сохранением канала связи с сервером управления, завершить вредоносные процессы, заблокировать подозрительные файлы. Автоматические сценарии реагирования и интеграция с SOAR-системами помогают оперативно сдерживать атаку. При этом вся необходимая информация в реальном времени передаётся аналитику, который может оценить контекст, принять взвешенное решение и при необходимости вмешаться вручную через live-консоль.
Дополнительный эшелон защиты — deception-технологии. Выйдя из контейнера на хост, злоумышленник начинает разведку: ищет учётные данные, ключи и конфигурации для дальнейшего продвижения. Если на хостах заранее размещены приманки в виде подложных учётных записей, файлов и других объектов, неотличимых от настоящих, любое обращение к ним мгновенно выдаёт атакующего, даже если сам побег из контейнера остался незамеченным.
Кроме того, EDR-система должна помогать и в предотвращении инцидентов. Решение автоматически выявляет ошибки конфигурации и избыточные права доступа, в том числе контейнеры с лишними capabilities (отдельные системные привилегии) и опасными точками монтирования томов. При обнаружении таких проблем EDR предоставляет аналитикам конкретные рекомендации по их устранению. Это позволяет устранять опасные настройки до того, как ими воспользуется атакующий.
Как выявляют уязвимости в контейнерах
Поиск уязвимостей в контейнерной среде устроен не так, как на обычных серверах. Отличается и способ устранения.
На сервере уязвимость закрывают обновлением. Вышел патч, установили — вопрос решён. Внутри контейнера изменения живут только до его пересоздания, а пересоздаётся он при каждом новом развёртывании, масштабировании или переносе на другой узел. Поскольку образ неизменяем, чтобы закрыть уязвимость, его нужно пересобрать.
Обнаружение уязвимости упирается в то же свойство контейнера. На сервере агент работает в такой же операционной системе, что и приложение, и получает состав установленного ПО от неё напрямую. В контейнер агент не ставят. В минималистичных образах нет ни командной оболочки, ни менеджера пакетов, ни среды, в которой он мог бы работать. Агент на узле видит контейнеры снаружи, но только уже запущенные, а образ до развёртывания для него не существует.
Поэтому образ читают напрямую, как набор файлов, и знать нужно все форматы учёта сразу. Debian ведёт текстовый файл /var/lib/dpkg/status, Alpine — простой индекс /lib/apk/db/installed. RHEL хранит базу RPM, которая в девятой версии переехала в /usr/lib/sysimage/rpm и сменила формат с Berkeley DB на SQLite. Своя книга учёта есть у каждой языковой экосистемы — от каталогов .dist-info у Python до package-lock.json у Node.js и метаданных META-INF внутри JAR-архивов у Java. Разбирать всё это нужно по собранной файловой системе. При анализе слоёв необходимо учитывать whiteout-записи, которыми в OCI-образах обозначается удаление файлов из нижних слоёв; иначе сканер может ошибочно считать удалённые компоненты присутствующими в итоговой файловой системе.
Зато обзор можно проверить до того, как он попадёт в промышленную среду. Реестры образов работают по общему для отрасли протоколу OCI Distribution Specification. По нему запрашивают манифест образа, получают список слоёв и разбирают их содержимое, не запуская контейнер. На классическом сервере такой возможности нет: там инвентаризация начинается после установки системы.
Собранный список пакетов — это лишь половина работы. Прямое сравнение версий с публичной базой уязвимостей даёт поток ложных срабатываний, потому что дистрибутивы переносят исправления в старые версии, не меняя номер. Пакет с уже закрытой уязвимостью по одному номеру версии неотличим от уязвимого.
Поэтому опираться приходится на трекеры безопасности самих дистрибутивов. Оставшиеся сотни записей ранжируют по вероятности эксплуатации и по наличию в перечнях подтверждённых атак вроде CISA KEV. Добавляет работы и то, что образ неизменен, а база уязвимостей обновляется ежедневно. Чистый вчера образ сегодня оказывается уязвимым, хотя в нём не поменялось ни байта.
И всё же чтение образа даёт только его состав. Запущен ли этот образ где-то в инфраструктуре, с какими привилегиями работает контейнер и что происходит внутри него сейчас, остаётся вопросом мониторинга. Одна и та же уязвимость в контейнере с избыточными привилегиями открывает дорогу к побегу на хост, а в изолированном остаётся малозначимой. А программу, установленную уже в работающем контейнере, как в разобранном выше примере с curl, в образе искать бессмысленно, её там нет.
Выводы
Контейнеры и микросервисная архитектура — одни из самых сложных зон контроля. Короткий жизненный цикл контейнеров, отсутствие единого источника событий в Linux и высокая динамика среды значительно усложняют задачу мониторинга.
Мониторинг во время исполнения закрывает лишь часть контейнерной безопасности. Уязвимости выявляют в образах до развёртывания, конфигурации кластера сверяют с эталонными требованиями, небезопасные манифесты отклоняют на входе, а возможности контейнера ограничивают политиками ядра.
Все эти меры работают с образом, описанием нагрузки или настройками среды, но не с поведением приложения. Атака же разворачивается внутри запущенного контейнера, и зафиксировать её можно только там.
Эффективность защиты контейнерных сред определяется не только скоростью реагирования, но и глубиной видимости, качеством контекста и способностью вовремя устранять системные слабости. Именно поэтому выбор EDR-решения — это не просто про мониторинг. Речь о способности организации противостоять быстрым и часто «бесследным» атакам в самой динамичной части инфраструктуры.


