



Рынок Security Operations Center переживает изменения: ИИ-инструменты активно внедряются, автоматизируя рутинные задачи. Но готовы ли мы передать им право принятия решений без участия человека? Эксперты рынка обсудили, какие процессы уже готовы к автономности, а где по-прежнему необходим аналитик.
- 1. Введение
- 2. Что изменилось за год?
- 3. Архитектура автономного SOC
- 4. ИИ-помощник vs ИИ-агент: границы, мультиагентность и доверие
- 5. С чего начать внедрение автономности?
- 6. Прогнозы: какая ставка на автономность может оказаться ошибочной
- 7. Выводы
Введение
Security Operations Center переживает фундаментальные изменения. Если раньше главным вопросом было, как автоматизировать рутинные задачи аналитиков, то сегодня на первый план выходят новые вызовы: ИИ-агенты, мультиагентные системы, автономное реагирование и растущая сложность инфраструктуры. Но главный вопрос остаётся открытым — готовы ли компании передать ИИ право принятия решений без участия человека?
Эксперты ведущих российских вендоров и провайдеров услуг обсудили, где заканчивается автоматизация SOC и начинается реальная автономность. Они разобрали, какие задачи уже можно передать ИИ-агентам, а в каких случаях участие аналитика по-прежнему обязательно.
Рисунок 1. Эксперты в студии AM Live
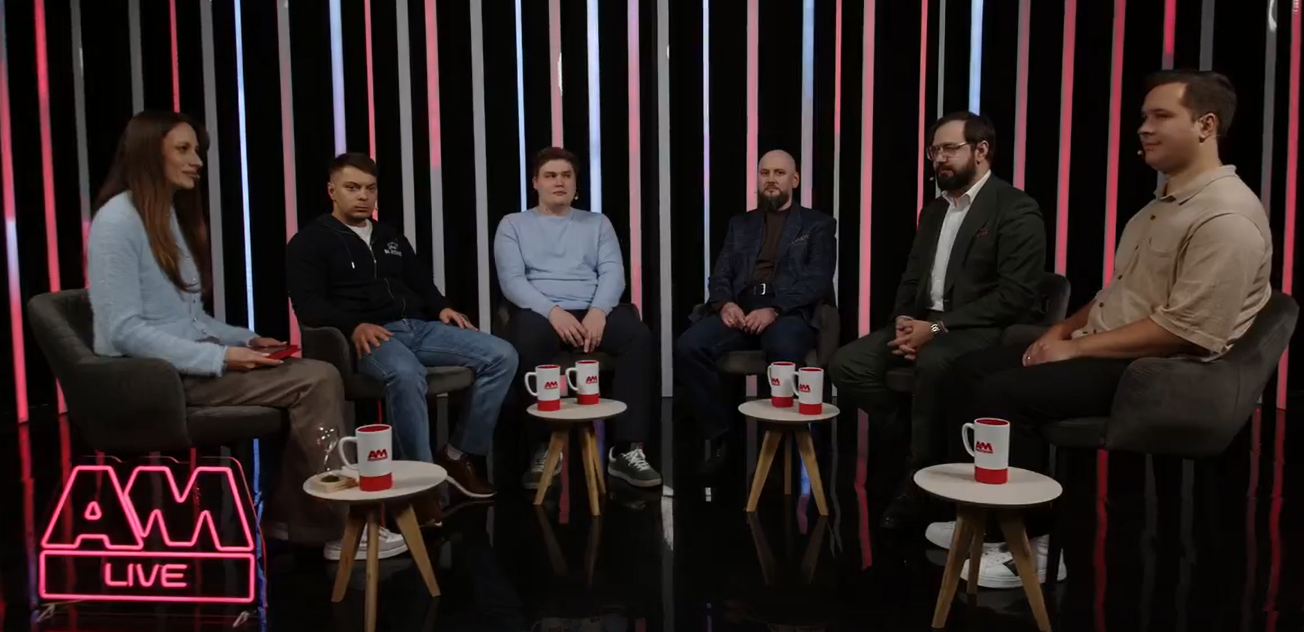
Участники эфира:
- Артём Кильдюшев, лидер по развитию и сопровождению MaxPatrol O2, Positive Technologies.
- Владимир Зуев, технический директор центра мониторинга и реагирования на кибератаки, RED Security.
- Максим Жевнерёв, руководитель направления технологического развития JSOC, ГК «Солар».
- Михаил Карпенко, старший инженер по информационной безопасности, Security Vision.
- Андрей Шаляпин, руководитель центра мониторинга и реагирования на киберугрозы, BI.ZONE.
Ведущий и модератор эфира — Елизавета Шатунова, начальник Центра реагирования Подразделения ИБ, ГУП «Московский метрополитен».
Что изменилось за год?
Андрей Шаляпин считает, что за прошедший год фундаментальных сдвигов не произошло. Сейчас наблюдается скорее эволюционное развитие. Однако он отметил два момента.
Первое — это смещение фокуса с витринных процессов SOC на второстепенные процессы сопровождения. Если раньше все автоматизировали работу аналитика — алерты, инциденты, то сегодня фокус смещается на мониторинг здоровья компонентов технологического стека, поиск аномалий в телеметрии (не с целью выявить атаку, а с целью выявить проблемы с мониторингом), автоматическое написание парсеров.
Также наблюдается смещение фокуса в сторону мультиагентных систем. Если первое время LLM-модели внедрялись как ассистенты, помогающие аналитику решить задачу, то сегодня речь идёт о совокупности агентов, каждый из которых узкоспециализирован и решает свою конкретную задачу. Результаты одного агента являются входными данными для другого, и вместе они реализуют автономность.
Андрей Шаляпин, руководитель центра мониторинга и реагирования на киберугрозы, BI.ZONE
Михаил Карпенко добавил, что продукты класса SOAR и XDR существуют давно, и автоматические действия выполнялись и раньше. Но за последний год стало больше доверия к ИИ-моделям. Теперь они выполняют не только сбор, анализ и суммаризацию данных — им доверяют всё больше действий по реагированию, в том числе восстановление конфигурационных файлов.
До какого этапа инцидент разбирается без аналитика?
Владимир Зуев высказал мнение, что система может разобрать инцидент до этапа установки первичного вердикта. Мультиагентная система собирает всю необходимую телеметрию, проводит обогащение контекста. Аналитику нужно просто верифицировать, что всё отработало корректно, и принять решение. Однако нажимать на кнопку всё ещё должен аналитик.
Андрей Шаляпин дополнил: если смотреть на весь жизненный цикл инцидента, то автономность может дойти до этапа containment — локализации и первичных действий по реагированию. Но только для типовых инцидентов, это очень ограниченный набор случаев. При этом ИИ может сформировать последовательность задач на реагирование, а их реализация уже выполняется классическими инструментами автоматизации.
Максим Жевнерёв продолжил мысль: при использовании любого инструмента — классических алгоритмов или ИИ-агентов — ключевой вопрос в том, в какой момент возникает страх. Большая часть задач по анализу данных и сбору контекста уже решается всеми. Дальше можно идти туда, где риск минимален: если автоматизации можно доверить остановку служб и изменение конфигурационных файлов и это не остановит бизнес, то почему бы нет? Это одна из возможностей сократить затраты и время на реагирование.
Максим Жевнерёв, руководитель направления технологического развития JSOC, ГК «Солар»
Какие процессы в L1 технически можно вывести в автоматизацию?
Михаил Карпенко считает, что в автоматизацию следует выводить те процессы, в которых уже есть уверенность, что их можно передать. Обогащение, суммаризация, сбор телеметрии делались давно. А вот создание бэкапов и восстановление конфигураций (если есть уверенность в корректности этих действий) тоже можно передавать автоматике. Это сократит время реагирования и в перспективе может перерасти в полное закрытие инцидента.
Максим Жевнерёв добавил, что количество инцидентов, в которых действительно нужен этап реагирования, составляет десятые доли процента от общего числа. Роль L1 меняется: если раньше приходилось перебирать большой объём данных и искать признаки инцидента, то сейчас данные уже обработаны, контекст есть, и задача смещается в сторону реагирования.
Эксперт также предупредил, что ИИ-модели и агенты дороги с точки зрения железа. Если внутри компании нет готовой инфраструктуры, развёртывание с нуля обойдётся дорого и проще нанять людей. Виртуальный эксперимент показал, что полный отказ от первой линии не окупается. Однако если в компании уже есть готовая инфраструктура, можно задействовать локальные модели или облачных провайдеров. Эффект проявляется на масштабе: если раньше 90 человек обслуживали 200 заказчиков, то теперь теми же ресурсами можно обслуживать 500.
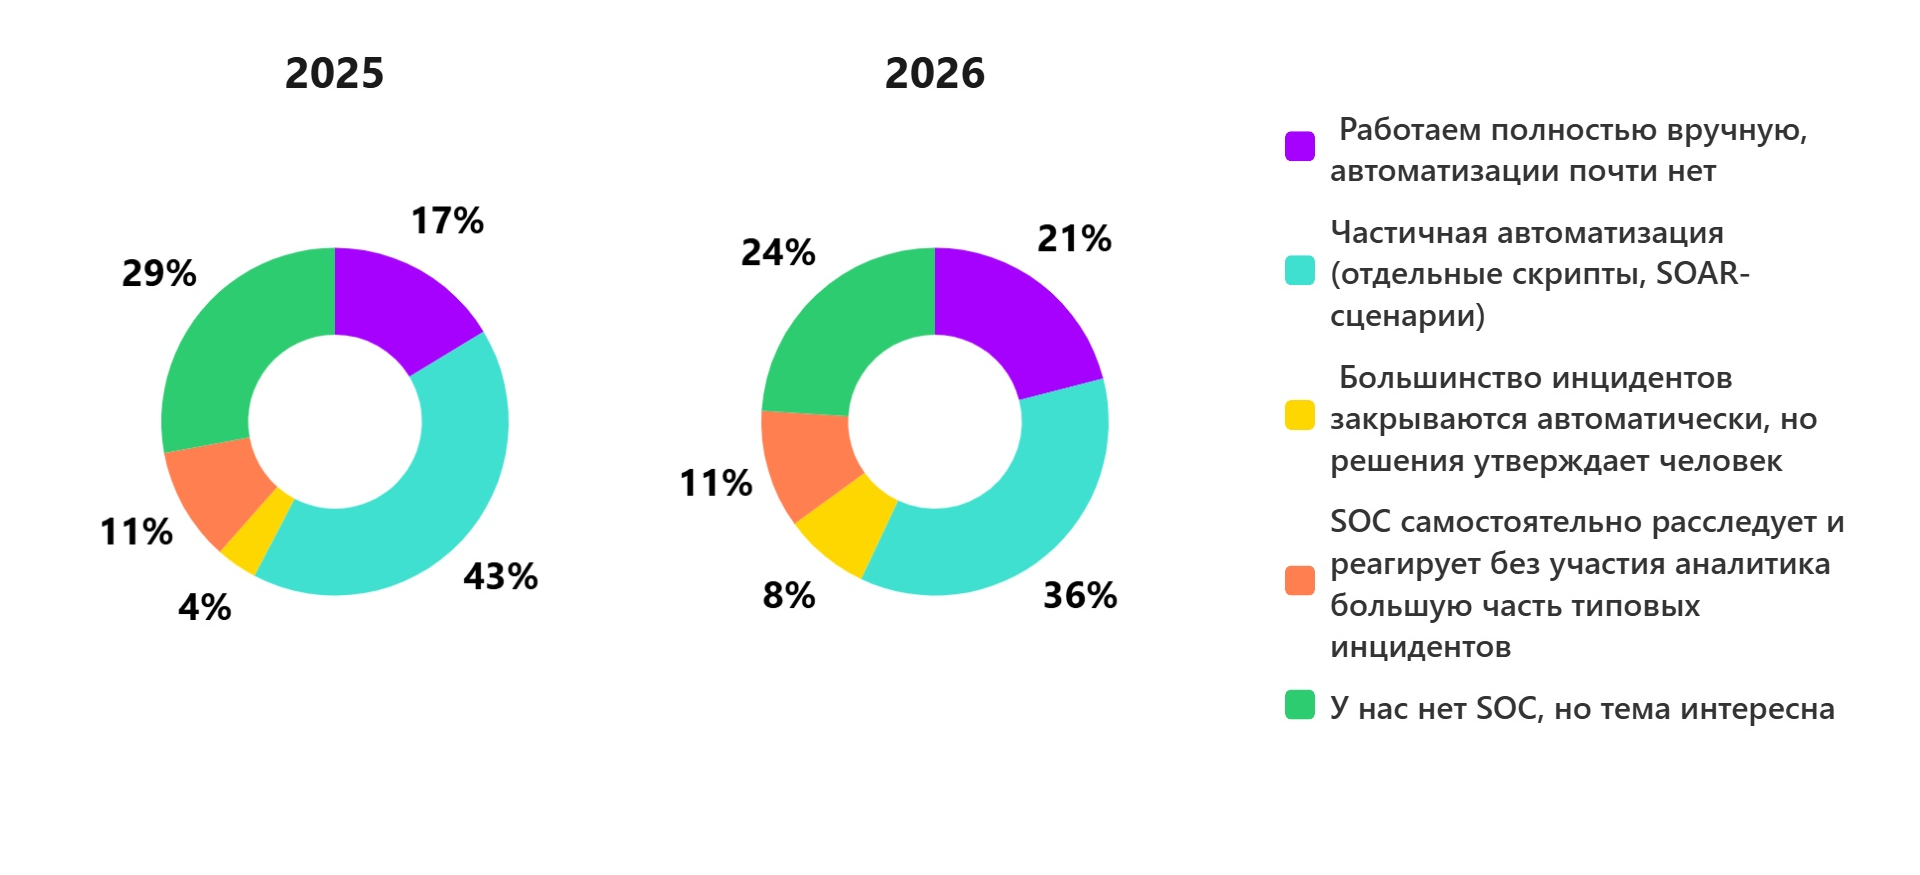
В первом опросе зрители ответили, где сейчас находится их SOC по уровню автономности:
- Частичная автоматизация (отдельные скрипты, SOAR-сценарии) — 36%.
- Нет SOC, но тема интересна — 24%.
- Работают полностью вручную, автоматизации почти нет — 21%.
- SOC самостоятельно расследует и реагирует без участия аналитика большую часть типовых инцидентов — 11%.
- Большинство инцидентов закрываются автоматически, но решения утверждает человек — 8%.
Рисунок 2. Где сейчас находится ваш SOC по уровню автономности?
Что оказалось сложнее всего автоматизировать?
Владимир Зуев считает, что самым сложным было добиться системности и отсутствия стохастичности в результатах работы агентов на одних и тех же датасетах. Абсолютно одинаковые агенты с одинаковыми скиллами на двух рабочих станциях могут выдавать разные результаты. Это требует дополнительного слоя инженерно-промптовой работы, чтобы с ИИ работать так же, как с первой линией.
Владимир Зуев, технический директор центра мониторинга и реагирования на кибератаки, RED Security
Артём Кильдюшев согласился и добавил, что ключевая проблема — это барьер доверия. Заказчики хотят автоматизацию реагирования, но когда дело доходит до практических реализаций, сталкиваются со страхом и недоверием. Проявляется здравый консерватизм — нежелание отдавать машине действия, которые могут навредить бизнес-процессам.
«Одна из наших основных задач — придумать, как снизить этот барьер. Качество растёт, доверять становится всё легче. Через пару лет будет легче доверять и определённым действиям по реагированию. Это путь, который мы должны пройти».
Максим Жевнерёв поделился, что самым тяжёлым этапом было принятие неизбежности ошибок. Модели ошибаются, галлюцинируют, работают некорректно. Но если посмотреть на работу первой линии из людей, процент ошибок не меньше, а где-то даже больше. Важно перешагнуть через этот этап и принять, что ошибки неизбежны. Дальше нужно думать, как их контролировать и исправлять.
Архитектура автономного SOC
Артём Кильдюшев разделил архитектуру на функциональные слои. Первый и самый главный слой — данные. Без данных и места, где их хранить, автономный SOC невозможен. Нужна нормальная телеметрия, запас данных, контекст. Второй компонент — сохранение детерминированной логики в виде детектов в SIEM. Нельзя сделать автономный SOC полностью на детектировании аномалий и ML-детекторах. Третий слой — LLM-модели.
Артём признался, что два года назад считал большие языковые модели неприменимыми в SOC из-за дороговизны и сложности настройки. Но с развитием LLM мнение изменилось: для автономного SOC (именно автономного, а не автоматизированного) LLM необходима.
«Автономный SOC невозможен до тех пор, пока мы будем вручную перепроверять всё, что сделал ИИ. Когда эта необходимость отпадёт и ИИ будет сам себя проверять, тогда мы сможем говорить об автономности».
Артём Кильдюшев, лидер по развитию и сопровождению MaxPatrol O2, Positive Technologies
Андрей Шаляпин добавил про важный компонент: нужно очень много GPU для работы LLM, и очень дорогих.
Что под капотом у российских SOC — свои LLM или opensource? Артём Кильдюшев ответил, что используются opensource-модели с дообучением. Для автоматизированных систем должна быть локальная модель, развёрнутая у доверенного поставщика.
Максим Жевнерёв отметил, что 15 лет назад история с облачными SOC вызывала у клиентов шок — «как можно забрать логи в облако?» Сейчас это не является проблемой. Есть данные, которые не нужно отдавать наружу, и здесь хорошо работает LLM-роутер — инструмент, который в зависимости от типа инцидента и контекста выполняет логирование, аудит, перенаправляет данные в разные модели, оркестрирует работу агентов и перепроверяет результаты.
Артём Кильдюшев считает облачные провайдеры нормальной практикой: в мире строятся ЦОДы за миллиарды долларов, и централизация неизбежна. При передаче данных должна быть возможность маскирования и анонимизации полей — в логах безопасности чувствительных данных, по его оценке, максимум около 5%.
Если есть возможность маскировать данные и фильтровать их по источнику, не отправляя в облако, то препятствий нет. Вышел приказ ФСТЭК № 117, который не запрещает отдавать данные в облако — всё остаётся на усмотрение оператора персональных данных.
Проблема возникает только при развёртывании полностью локального автономного SOC на собственных мощностях — тогда нужны значительные вложения в инфраструктуру. Самое важное — нанять людей, которые будут эту инфраструктуру поддерживать: проблема не столько в самих серверах, сколько в необходимости поддерживать всю инфраструктуру в рабочем состоянии.
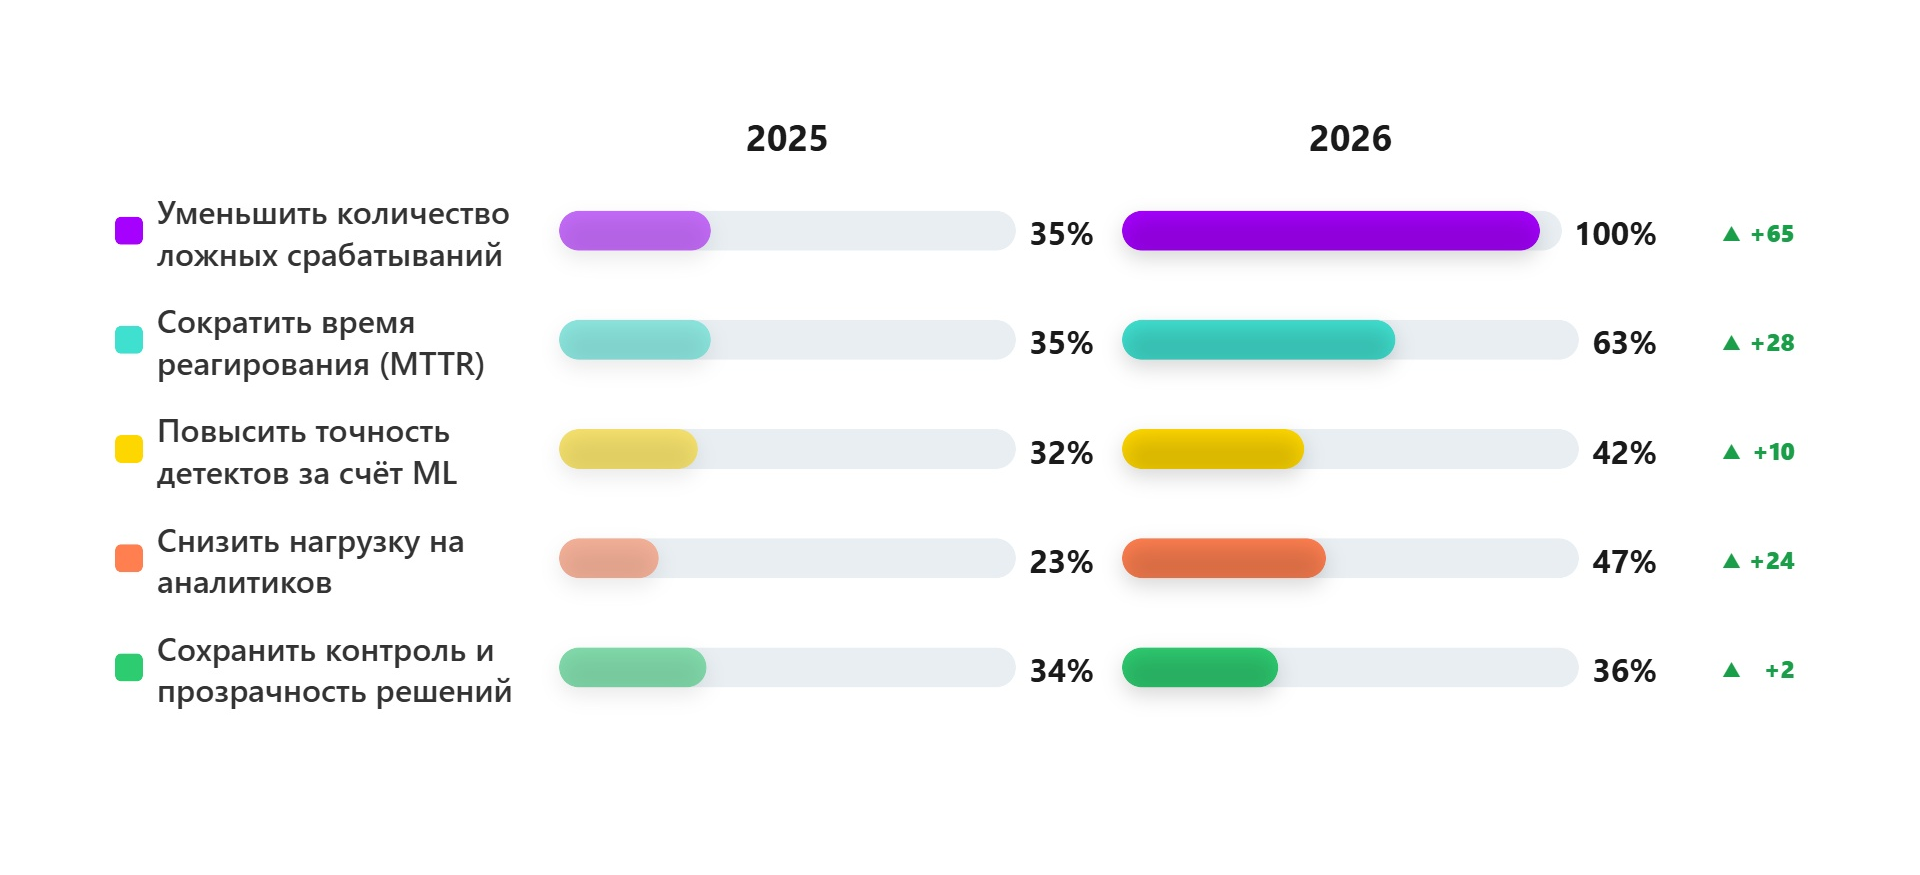
Во втором опросе зрители поделились, что сегодня важнее для их SOC (мультивыбор):
- Уменьшить количество ложных срабатываний — 100%.
- Сократить время реагирования (MTTR) — 63%.
- Снизить нагрузку на аналитиков — 47%.
- Повысить точность детектов за счёт ML — 42%.
- Сохранить контроль и прозрачность решений — 36%.
Рисунок 3. Что сегодня важнее для вашего SOC?
ИИ-помощник vs ИИ-агент: границы, мультиагентность и доверие
Андрей Шаляпин объяснил разницу: ИИ-помощник — это чат-бот, который предоставляет человеку интерфейс для обработки данных. Агент — это про автономность: он умеет извлекать, интерпретировать и обрабатывать данные, у него есть скиллы и тулы, за счёт которых он может ходить в третьи системы, дёргать API, запускать задачи реагирования. Граница в том, что агент может весь процесс автоматизировать от начала и до конца, а помощник — только ассистировать человеку.
Михаил Карпенко добавил, что ИИ-помощник может выступать как MCP для агентов: вы говорите помощнику, что сделать, и он по архитектуре находит агента, который должен запустить определённый инструмент.
Как заказчику отличить реального ИИ-агента от обычной автоматизации? Михаил ответил, что нужно поставить два максимально похожих кейса, но чуть-чуть отличающихся. Обычная автоматизация приведёт к одному точному результату, а ML и ИИ ответят чуть-чуть по-разному.
Что эффективнее — один универсальный агент или несколько специализированных? Михаил Карпенко выбрал бы агентов, которые используют необходимые инструменты вместо него.
Михаил Карпенко, старший инженер по информационной безопасности, Security Vision
Владимир Зуев — за мультиагентную архитектуру. Когда у каждого агента есть конкретная роль, безопасникам проще за ним следить. Этот вопрос волнообразно появляется и исчезает в информационном поле, однако ролевая модель даёт агенту больше возможностей оперировать данными: ему достаточно контекста для локальной задачи, а не для всей цепочки сразу. Дополнительно появляется возможность точнее мониторить, что агент делает и куда может обращаться, чётче выставлять гардрейлы и снижать риск того, что агент начнёт жечь токены или заниматься посторонними вещами.
При этом это не блок-фактор: в ряде случаев подобное огораживание агентов, наоборот, приводит к тому, что они не могут работать. Такие кейсы встречались на практике. Тем не менее навык любого специалиста SOC можно декомпозировать на набор агентов, и в такой архитектуре система работает лучше.
Максим Жевнерёв описал классический сценарий: несколько агентов с разными инструкциями обрабатывают одну задачу. Один пытается найти подтверждение, второй как критик пытается его разнести, третий как арбитр собирает всё и делает вывод.
Понятно, что на каждом уровне действуют лимиты, при превышении которых результат отправляется дальше — в линию, человеку, аналитику, куда угодно — для принятия решения и, соответственно, корректировки логики.
Артём Кильдюшев добавил, что в Positive Technologies практикуют построение гипотез. Когда есть разные вердикты от разных агентов либо какая-то непонятная активность, верховный агент формирует набор гипотез, из которых выбирается наиболее подходящая — что конкретно произошло.
На примере запуска вредоносного процесса как инцидента: разные агенты ходят, собирают контекст по этому инциденту, после чего выдвигается гипотеза о том, что это был за процесс. Гипотеза номер один может звучать так: это системный процесс, вызванный определённым программным обеспечением, поэтому это не инцидент. Под ней остаётся ряд других гипотез, которые тоже были проверены, но по каким-то причинам агент решил, что они не релевантны для данного кейса.
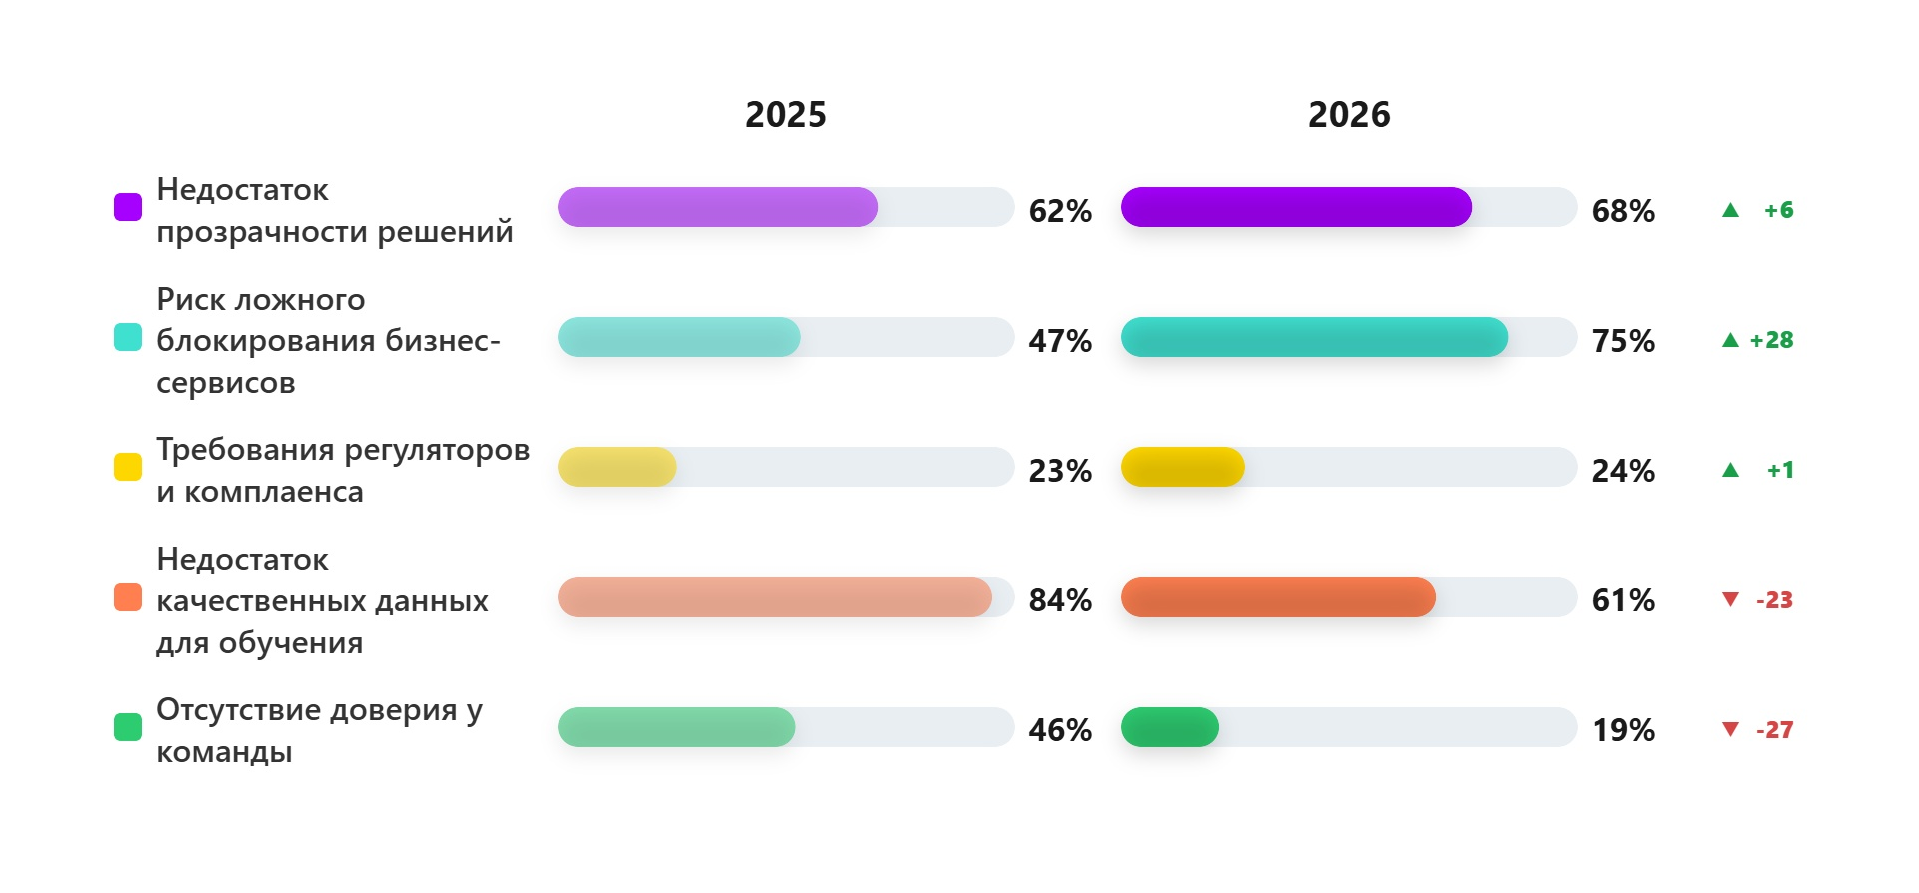
В третьем опросе выяснилось, что мешает доверять ИИ в SOC (мультивыбор):
- Риск ложного блокирования бизнес-сервисов — 75%.
- Недостаток прозрачности решений — 68%.
- Недостаток качественных данных для обучения — 61%.
- Требования регуляторов и комплаенса — 24%.
- Отсутствие доверия у команды — 19%.
Рисунок 4. Что мешает доверять ИИ в SOC?
С чего начать внедрение автономности?
Михаил Карпенко:
«Самый первый кейс, который можно реализовать, — это первый вами описанный плейбук. То, что вы составили первым и что кажется вам максимально понятным и управляемым, и нужно автоматизировать в первую очередь».
Максим Жевнерёв:
«Тот процесс, который отнимает у вас больше всего времени и в котором вы постоянно выполняете одни и те же действия».
Владимир Зуев:
«Нулевой шаг — это поставить цель и понять, что вы хотите в целом. Зачем вам нужна автономность? Если нужен самый безопасный кейс, то попробуйте автоматизировать регистрацию, интерпретацию запросов, которые пользователи присылают в SOC».
Артём Кильдюшев:
«Те сценарии, по которым у вас больше всего данных. Это проще всего перевести в автономный режим».
Андрей Шаляпин:
«По поводу критериев — то, что максимально повторяется, максимально типизировано — это нужно переводить в автоматизацию. Конкретные процессы в контексте SOC: разбор алертов и классификация FP/TP. И второе — это работа с исключениями. Тоже достаточно тяжёлый процесс, который хочется автоматизировать в первую очередь. И он достаточно хорошо автоматизируется с применением ИИ».
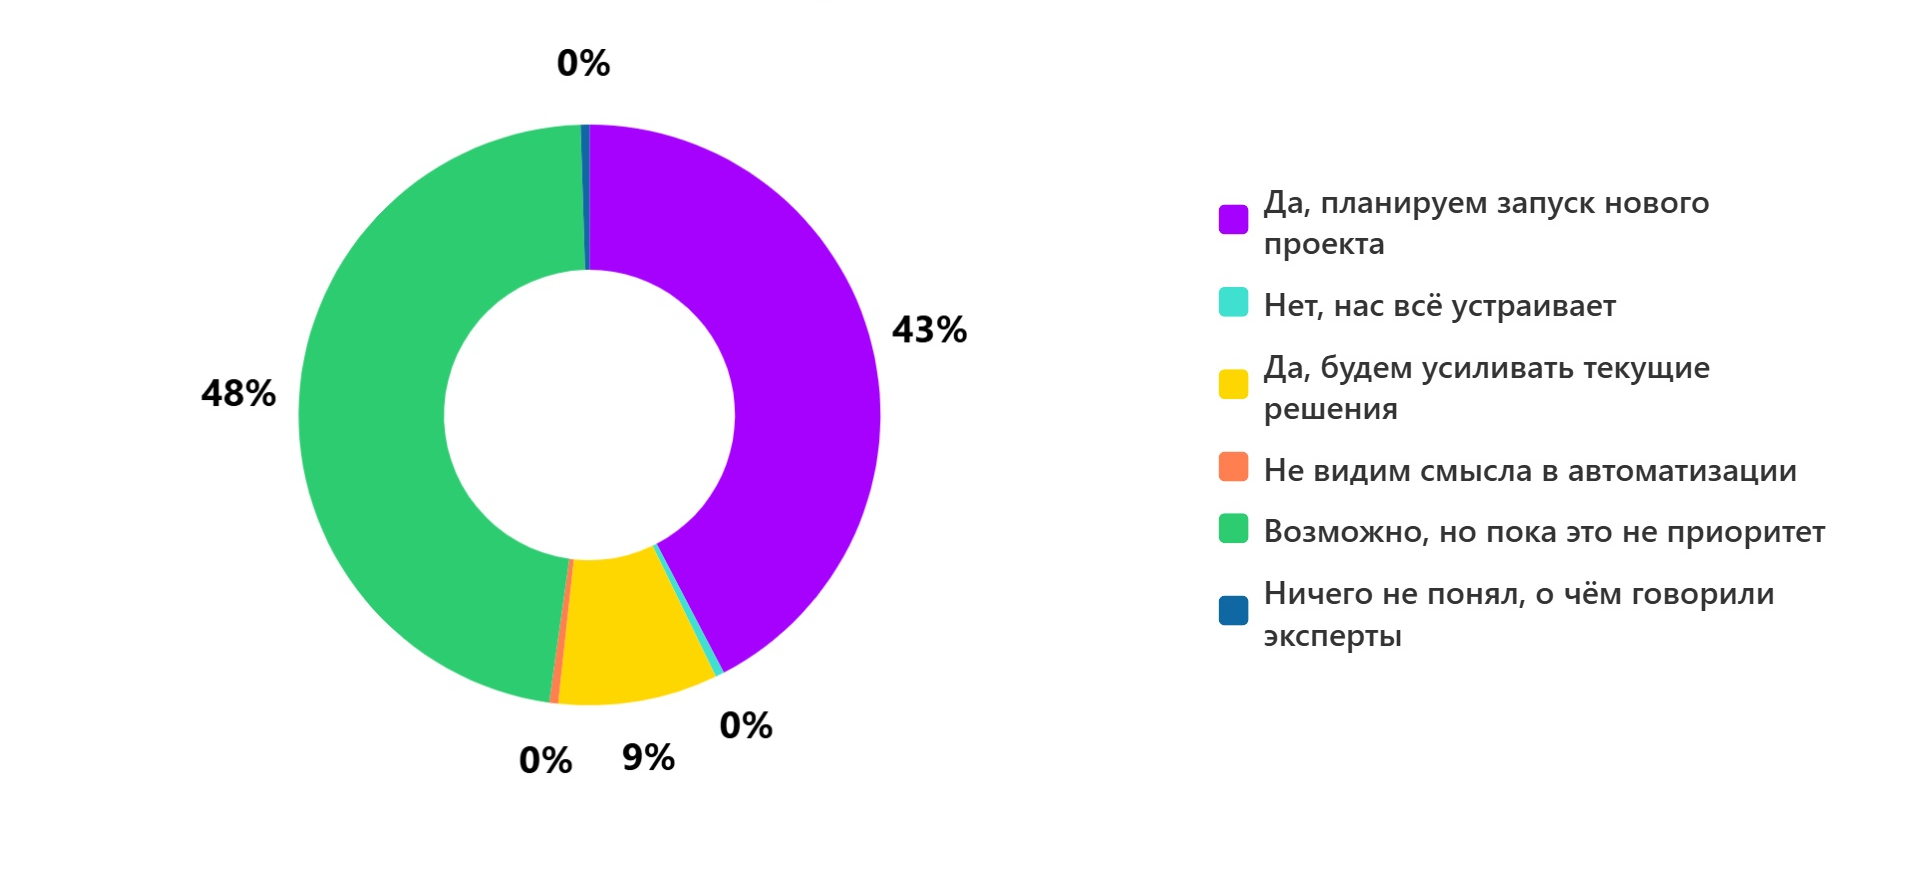
Финальный опрос показал, планируют ли зрители внедрять или усиливать автоматизацию SOC после эфира.
- Возможно, но пока это не приоритет — 48%.
- Планируют запуск нового проекта — 43%.
- Будут усиливать текущие решения — 9%.
- Всё устраивает — 0%.
- Не видят смысла в автоматизации — 0%.
- Ничего не поняли, о чём говорили эксперты — 0%.
Рисунок 5. Планируете ли вы внедрять или усиливать автоматизацию SOC после эфира?
Прогнозы: какая ставка на автономность может оказаться ошибочной
Андрей Шаляпин:
«Излишние ожидания от автономности. Не нужно думать, что SOC станет чёрным ящиком, куда зашло событие и вышел прореагированный инцидент. Ни одна SIEM не работает из коробки, здесь то же самое».
Артём Кильдюшев:
«Автономность не появится путём внедрения одной технологии. Это не проект по внедрению чего-то. Автономность — это путь, к которому нужно идти через автоматизацию, через боль и страдания. Сгрузить всё ИИ — ложное ожидание, оно не заработает. Мы всё равно должны проделать огромную работу».
Максим Жевнерёв:
«Важно не перепрыгивать через ступеньки и не надеяться на серебряную пулю, волшебную таблетку, которая сразу уберёт 90% проблем и позволит перескочить на самый верхний уровень».
Михаил Карпенко:
«Главными ограничителями автономности через 3–5 лет могут стать доверие и ответственность, а также специалисты — если их не обучать работать с моделями, это может стать проблемой».
Елизавета Шатунова подвела итог обсуждения: рынку не стоит строить завышенных ожиданий — ни от автоматизации, ни тем более от автономности, и важно понимать, что это тернистый путь не на один и не на два года, а на три и более. Она также отметила, что доверие и ответственность — два неразрывных ограничителя автономности.
Елизавета Шатунова, начальник Центра реагирования Подразделения ИБ, ГУП «Московский метрополитен»
Выводы
Автономность SOC в 2026 году остаётся скорее направлением движения, чем достигнутым состоянием. За прошедший год фундаментального прорыва не произошло: рынок развивается эволюционно, а не революционно. Главные сдвиги касаются не столько технологий, сколько фокуса. Происходит смещение внимания с витринных процессов на сопровождение инфраструктуры и переход от одиночных LLM-ассистентов к мультиагентным системам, где каждый агент решает узкую задачу, а результаты его работы становятся входными данными для следующего.
Автономность сегодня доходит до этапа вынесения первичного вердикта и, в ограниченном наборе типовых случаев, до локализации и первичного реагирования. Сбор телеметрии, обогащение, суммаризация и классификация уже передаются машине, тогда как действия, способные навредить бизнесу, по-прежнему требуют участия человека. Ключевой барьер — не технический, а психологический: страх ошибки и недоверие к модели. При этом эксперты сходятся в том, что процент ошибок людей на первой линии сопоставим с этим показателем у ИИ, а иногда он даже выше, поэтому задача не в том, чтобы избежать ошибок, а в том, чтобы научиться их контролировать и исправлять.
Архитектура автономного SOC строится на трёх слоях: данные и место их хранения, детерминированная логика в виде детектов и LLM-модели. Без качественной телеметрии и накопленного контекста автономность невозможна, а отказ от классических детекторов в пользу одних лишь ML-моделей неработоспособен.
Вопрос локальных или облачных моделей перестал быть принципиальным: централизация вычислений неизбежна, а маскирование и анонимизация данных снимают большую часть возражений. Основная сложность — не серверы, а люди, способные поддерживать инфраструктуру в рабочем состоянии. Главные ограничители автономности на горизонте трёх-пяти лет — доверие и ответственность, а также специалисты, умеющие работать с моделями.
Начинать внедрение стоит с процессов, которые отнимают больше всего времени и выполняются по одному и тому же сценарию: плейбуки, разбор алертов, классификация FP/TP, работа с исключениями, регистрация и интерпретация запросов пользователей. Критерий прост — максимальная повторяемость, типизированность и наличие большого массива данных.
Главный вывод эфира: автономность не появится путём внедрения одной технологии. Это не проект, а путь, который проходит через автоматизацию, накопление данных, обучение моделей и постепенное расширение зоны доверия. Успех здесь зависит не от выбора конкретного вендора или модели, а от готовности выстраивать процесс итеративно, фиксируя результаты каждого этапа и корректируя логику по мере накопления опыта.
Организациям, которые только начинают, стоит сосредоточиться на фиксации собственных действий: без документации того, как сегодня работает аналитик и какие решения принимает, автоматизировать будет нечего. Итоговая цель — не замена человека, а перераспределение его роли: аналитик становится оператором агентов, контролирующим качество и вмешивающимся там, где последствия ошибки слишком велики.
Телепроект AM Live еженедельно приглашает экспертов отрасли в студию, чтобы обсудить актуальные темы российского рынка ИБ и ИТ. Будьте в курсе трендов и важных событий. Для этого подпишитесь на наш YouTube-канал. До новых встреч!


