


Android 17 покажет, какие данные покидают закрытую ИИ-песочницу

Android 17 покажет, какие данные покидают закрытую ИИ-песочницу

Android 17 покажет, какие данные покидают закрытую ИИ-песочницу

В Android 17 QPR2 Beta 4 появился отдельный раздел для журналов Private Compute Core — изолированной среды, в которой работают локальные функции машинного обучения. Пользователи смогут отслеживать исходящие данные, скачивать логи на смартфон и удалять их.

Private Compute Core обслуживает Live Caption, Now Playing, Smart Reply и другие интеллектуальные возможности Android.

Среда отделена от приложений и облачных сервисов, чтобы конфиденциальная информация обрабатывалась непосредственно на устройстве. Раньше пользователю оставалось просто верить, что песочница действительно ведёт себя прилично. Теперь за ней можно будет немного присмотреть.

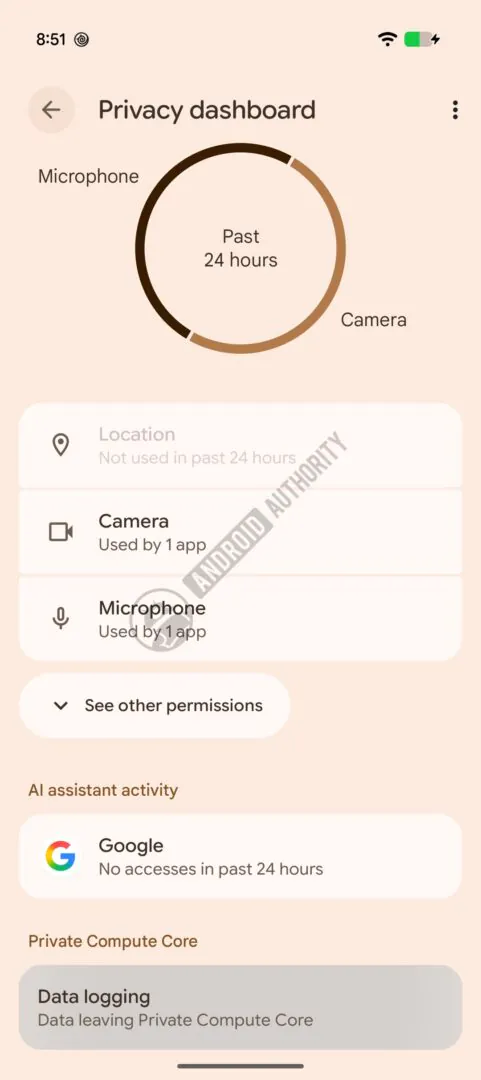
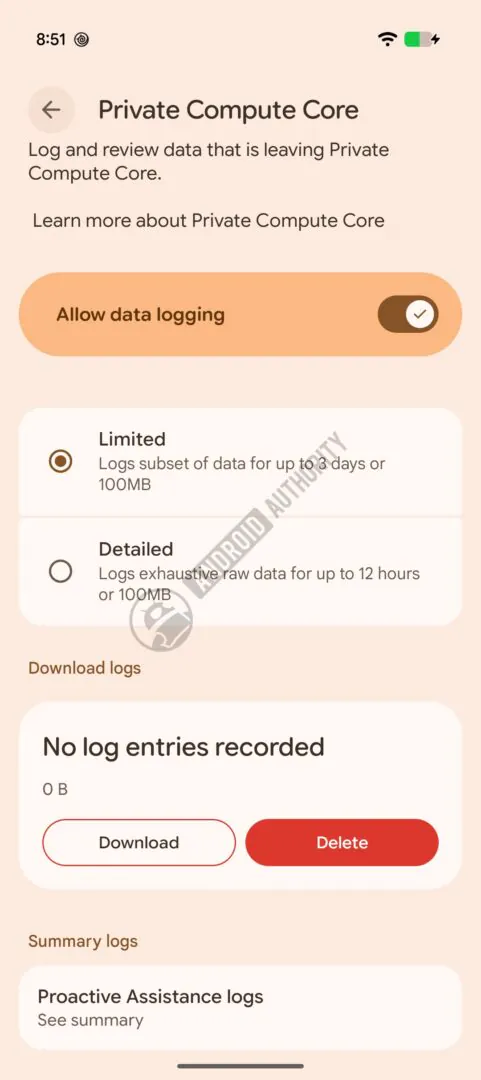
Новое меню «Журналирование данных» расположено в панели конфиденциальности. Сбор информации разрешается полностью отключить или вести в одном из двух режимов.


Ограниченный режим сохраняет часть данных в течение трёх дней либо до достижения объёма 100 МБ. Подробный собирает необработанные журналы максимум за 12 часов и с тем же лимитом в 100 МБ. При его включении Android отдельно предупреждает, что в файлах может оказаться персональная информация.

Пользователь сможет загрузить собранные логи в память устройства для самостоятельного изучения или удалить их одной кнопкой. Отдельный раздел покажет краткие сводки по работе конкретных функций, включая Proactive Assistance.

Пока инструмент доступен только участникам тестирования Android 17 QPR2 Beta 4, поэтому его интерфейс и возможности ещё могут измениться до стабильного релиза.

Подпишитесь на новости

Google поддержит единый запрет на обучение ИИ через robots.txt

Владельцам сайтов обещают упростить отказ от использования их материалов для обучения нейросетей. Google поддержит общий механизм в robots.txt: вместо отдельных инструкций каждому ИИ-провайдеру можно будет задать единую настройку для участников инициативы.

О планах компания сообщила в блоге Search Central. Поддержку механизма намерены запустить в 2027 году.

В основе лежат разработки рабочей группы AIPREF при IETF. В robots.txt появится общий маркер политики, который позволит обозначить предпочтения сайта относительно обучения ИИ.

Google планирует трактовать запрет через такой маркер аналогично запрету Google-Extended, если отдельная инструкция для него не задана. При этом существующие настройки для конкретных компаний сохранятся: можно будет установить общее правило и отдельно уточнить условия для отдельных провайдеров.

Для издателей это потенциально меньше возни с растущим списком ИИ-ботов. Но универсального технического щита здесь нет: robots.txt сообщает правила использования контента, а не перекрывает доступ к серверу. Эффект зависит от того, какие компании поддержат механизм и будут соблюдать инструкции.

Инициатива пока остаётся предложением, которое продолжат дорабатывать и стандартизировать.

RSS: Новости на портале Anti-Malware.ru