



DrawnApart — новая техника снятия отпечатков пользователей с помощью GPU

DrawnApart — новая техника снятия отпечатков пользователей с помощью GPU

DrawnApart — новая техника снятия отпечатков пользователей с помощью GPU

Команда экспертов из университетов Франции, Израиля и Австралии показали интересный метод создания уникальных цифровых отпечатков пользователей Сети и веб-отслеживания. Для этого исследователи задействовали графические процессоры самих объектов слежки (GPU).

В ходе эксперимента специалисты использовали 2550 устройств с 1605 различными CPU-конфигурациями. Это позволило продемонстрировать, что их метод — «DrawnApart» — может увеличить среднюю продолжительность отслеживания до 67%.

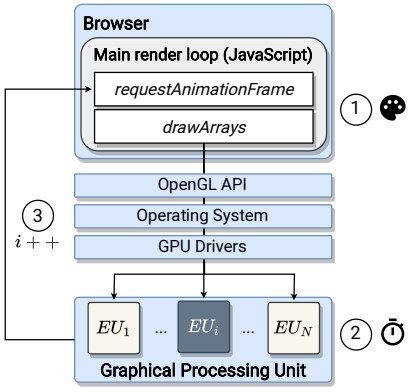
Для создания отличительных цифровых отпечатков эксперты использовали GPU целевых устройств и прибегали к помощи библиотеки WebGL. Как известно, этот кросс-платформенный API используется для рендеринга 3D-графики во всех современных браузерах.

Используя эту библиотеку, метод DrawnApart может высчитать число и скорость исполнительных блоков в GPU.


Суть DrawnApart заключается в использовании коротких GLSL-программ, которые выполняются GPU отслеживаемого устройства. Команда исследователей разработала два вектора: метод вычисления на экране, при котором выполняется малое количество сложных вычислительных операций; метод «за кадром», который подвергает GPU более продолжительному, но менее интенсивному тесту.

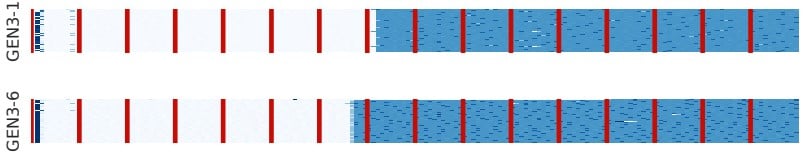
В результате эксперты получили отпечатки, состоящие из 176 замеров, взятых из 16 показателей, которые используются для создания цифрового отпечатка. Специалисты представили эти отпечатки визуально, чтобы продемонстрировать видимые отличия:


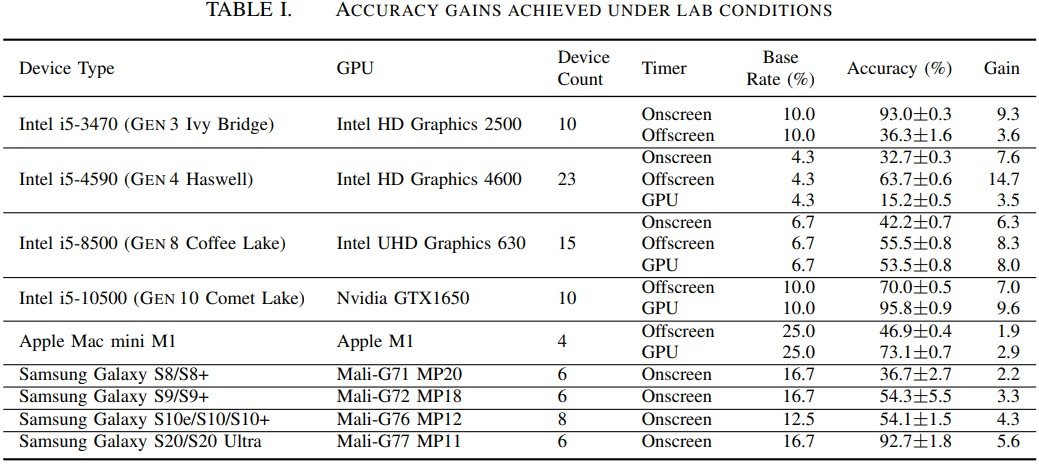
При этом в ходе тестов исследователи даже меняли другие аппаратные составляющие, что не повлияло на результат, поскольку отпечатки прямо зависели от GPU. На таблице ниже можно посмотреть, какие устройства использовали специалисты и насколько точными были результаты.

Подпишитесь на новости

Codex и Kimi провалили задачи после перевода промптов на русский

Попросили ИИ исправить код по-русски, а он сразу же решил обойтись без интернета и начал придумывать решение. Такое поведение заметила автор проекта worklore Валентина Конюхова: в её эксперименте Codex и Kimi K3.1 пропускали поиск, которым пользовались при англоязычных заданиях.

Подробности и методику она опубликовала на Хабре.

Автор провела 1350 прогонов: шесть задач, девять конфигураций агентов, задания на русском и английском (с подсказками и без них). У всех был доступ в интернет.

На одной задаче Codex с низким уровнем рассуждений нашёл нужный формат на форуме и справился во всех пяти англоязычных прогонах.


С русским заданием он ни разу не обратился в Сеть и получил ноль успешных решений. У Kimi K3.1 похожий провал произошёл на задаче с OAuth.

Зато заметка с нужным фактом возвращала результат до пяти успешных результатов из пяти. В среднем подсказки повышали успешность на 33 процентных пункта для английских заданий и на 39 — для русских. Язык самой заметки почти ничего не менял.


Стоит учитывать, что задач в примере было всего шесть, повторов немного, а причину изменения поведения автор не проверяла. Но на всякий случай смотрите в логи, искал ли агент ответ.

RSS: Новости на портале Anti-Malware.ru