



Утекли данные более 226 миллионов аккаунтов, Трой Хант изучил базу

Утекли данные более 226 миллионов аккаунтов, Трой Хант изучил базу

Утекли данные более 226 миллионов аккаунтов, Трой Хант изучил базу

Известный исследователь в области кибербезопасности Трой Хант проанализировал свежую базу скомпрометированных данных, в которой якобы присутствуют логины и пароли более чем от 226 миллионов аккаунтов. Специалист попытался выяснить, есть ли достаточные основания для внесения БД в его сервис Have I Been Pwned (HIBP).

В руки Троя Ханта попал файл «Cit0day.in_special_for_xss.is.zip», который весил в сжатом состоянии 13 Гб. Внутри ZIP-архива оказались две папки: «Cit0day [_special_for_xss.is]» и «Cit0day Prem [_special_for_xss.is]».

Далее Хант обнаружил целый зоопарк. Например, в первой директории он нашёл 14 669 .rar-файлов, а во второй — 8 949 таких же архивов. Содержимое файлов исследователь выложил на GitHub (первый файл и второй файл).

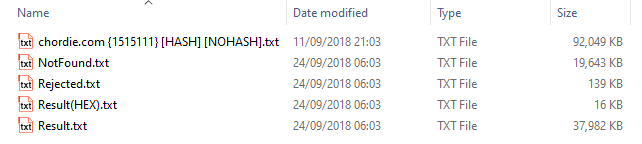
После этого специалист проанализировал архив «chordie.com {1.515.111} [HASH+NOHASH] (Arts)_special_for_XSS.IS.rar», поскольку он был наиболее объёмным. Внутри лежали пять текстовых файлов.


Самый крупный из .txt-файлов включал 1,5 млн строк, состоящих из адреса электронной почты и пароля в виде хеша MD5.

«Однако можем ли мы доверять указанной в файлах информации? Действительно ли связка "имейл-пароль" подлинная. Я проверил актуальность данных на площадке chordie.com, форуме для гитаристов», — рассуждает Трой Хант.

В результате оказалось, что указанный адрес электронной почты действительно есть в базе сайта — он принадлежит пользователю с ником «trawis». Хант заключил, что слитые учётные данные не являются фейком.

Всего в базе насчитывается 226 883 414 логинов и паролей. Если считать все данные валидными, то пользователям необходимо как можно скорее поменять пароли от своих аккаунтов. Напомним, что подобные утечки могут использоваться в дальнейшем в атаках с подбором паролей.

Подпишитесь на новости

Поток ИИ-слопа вынудил arXiv ввести лимит на новые статьи

Научный конвейер притормозили: с 1 октября arXiv разрешает каждому пользователю отправлять только две новые статьи за календарный месяц. Лимит общий для всех категорий, а отклонённая работа тоже расходует попытку. Написать текст за пару минут теперь недостаточно, придётся выбирать, что отправлять.

В блоге arXiv команда объясняет решение перегрузкой. В сентябре 2026 года репозиторий получил около 40 тысяч статей — вдвое больше, чем двумя годами ранее. Число обращений к сотрудникам и модераторам за месяц приблизилось к 9 тысячам.

Одной из причин называют генеративный ИИ. Он помогает раздувать небольшой результат до полноценной статьи или нарезать одно исследование на несколько публикаций (ту самую тактику салями). Новых выводов немного, зато повторяющегося текста хоть отбавляй.


Использование нейросетей не запрещено: о существенном применении нужно сообщать модераторам, а ответственность остаётся на авторах. Лимит касается всех отправителей, независимо от того, кто набирал текст.


Мера временная, она должна дать модераторам-добровольцам передышку, пока площадка обновляет правила и инструменты. При этом arXiv не проводит полноценное научное рецензирование.

RSS: Новости на портале Anti-Malware.ru