



7,5 млн записей пользователей Adobe Creative лежали открытыми в Сети

7,5 млн записей пользователей Adobe Creative лежали открытыми в Сети

7,5 млн записей пользователей Adobe Creative лежали открытыми в Сети

У Adobe есть база данных Elasticsearch, содержащая 7,5 миллионов записей, принадлежащих пользователям Adobe Creative Cloud. Кеш этой базы никак не был защищён, что позволяло любому получить доступ к информации клиентов. Нужно было только знать, где искать.

Справедливости ради стоит отметить, что пользовательские данные не были слишком конфиденциальными, однако с их помощью злоумышленники могли бы организовать более продуманные фишинговые кампании.

Боб Дьяченко, исследователь в области безопасности, заявил, что пользовательская информация лежала открытой около недели. Специалист сообщил Adobe о проблеме ещё 19 октября, в тот же день компания приняла меры.

Команда Comparitech утончила, что паролей или платёжной информации в открытом доступе не было.

На сегодняшний день непонятно, нашёл ли кто-нибудь БД с данными пользователей. Но если всё же злоумышленники вышли на базу, они точно попытаются организовать кампанию целевого фишинга.

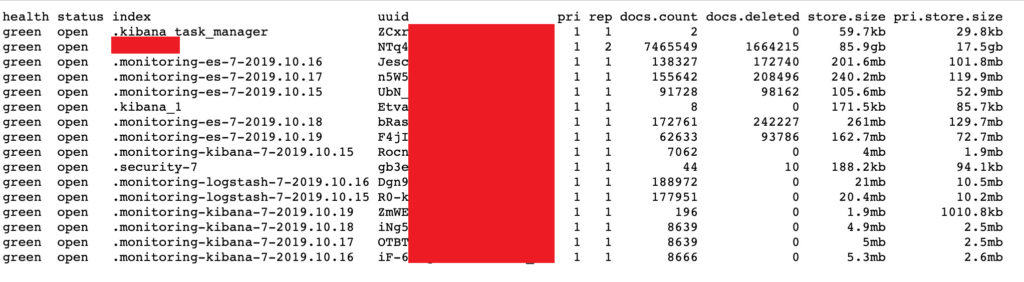
По словам обнаруживших утечку экспертов, размер базы кеша был близок к 86 Гб.

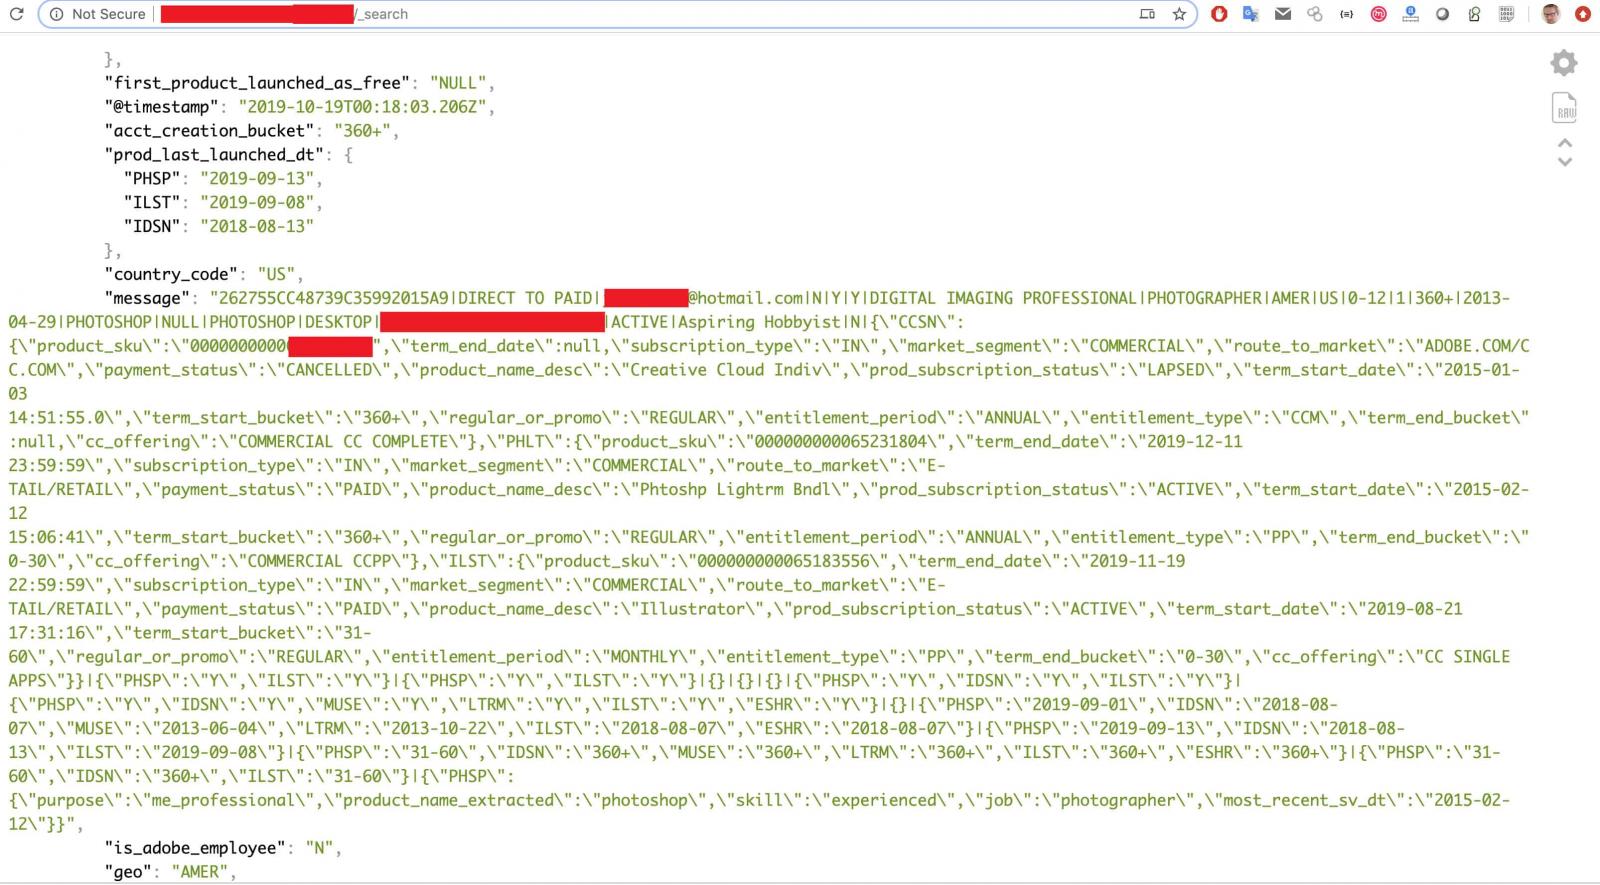
Дьяченко поделился скриншотом, на котором видно, какие именно данные лежали открытыми: адреса электронной почты, дата создания аккаунта, используемые клиентом продукты и статус оплаты.

Помимо этого, была и менее важная информация: статус подписки, является пользователь сотрудников Adobe, идентификатор пользователя, страна проживания и время последнего входа в учётную запись.

Сама компания уже успела опубликовать официальное заявление, в котором объясняется, что база данных была частью прототипа окружающей среды.

Подпишитесь на новости

В НГУ создали платформу для проверки качества данных, на которых обучают ИИ

В Новосибирском государственном университете разработали «Каппу» — платформу для управления данными, на которых обучают ИИ. Она должна помочь разобраться, кто подготовил датасет, что в нём меняли и откуда взялась ошибка. Потому что кормить модель мусором, а потом удивляться её ответам — довольно странно.

О разработке и возможности подключения других вузов сообщил сам НГУ. Университетам предлагают бесплатную облачную версию на серверах НГУ либо платную установку в собственной инфраструктуре.

«Каппа» поддерживает разметку и проверку данных, фиксирует версии наборов и авторство изменений. Исправление ошибки сохраняется в новой версии, чтобы при следующем обучении не наступать на те же грабли.

Платформа также позволяет проверять разные модели на подготовленных датасетах. При обучении фиксируются версия данных и параметры, после — результаты тестирования на эталонных наборах. Во время эксплуатации телеметрия помогает отслеживать ошибки и замечать отклонения.

Локальная установка рассчитана в том числе на случаи, когда конфиденциальные данные нельзя выносить за пределы организации.

В репозитории разработчиков среди задач проекта указаны контроль обучения, отслеживание авторства разметки и соблюдения стандартов. Здесь ставка на прослеживаемость: прежде чем требовать от ИИ безупречных ответов, полезно выяснить, чему именно его учили.

RSS: Новости на портале Anti-Malware.ru