



Иск на $35 млрд из-за сканирования лиц стал ещё ближе к Facebook

Иск на $35 млрд из-за сканирования лиц стал ещё ближе к Facebook

Иск на $35 млрд из-за сканирования лиц стал ещё ближе к Facebook

Facebook пока не смог остановить иск на $35 миллиардов, поданный разгневанными пользователями, считающими, что соцсеть перешла границы в использовании своей технологии распознавания лиц.

Девять окружных судей могли отклонить исковое заявление, однако решили в итоге дать ему ход. Таким образом, просьба Facebook не была удовлетворена.

В деле, которое слушал суд, речь идёт о том, что жители штата Иллинойс не давали согласия на сканирование загруженных ими фотографий с помощью системы распознавания лиц. Истцы утверждают, что их не проинформировали о хранении и сборе их данных с 2011 года.

Если суд встанет на сторону пострадавших, Facebook будет вынужден выплатить от $1000 до $5000 на каждого истца, коих семь миллионов. Нетрудно посчитать, что общая сумма в своём максимуме будет равна $35 миллиардам.

Один из судей, отклонив попытку Facebook замять дело, отметил, что собранные данные отсканированных лиц могут использоваться для разблокировки смартфонов, защищённых биометрической аутентификацией. И это не говоря уже о возможном интересе разведки к подобным данным.

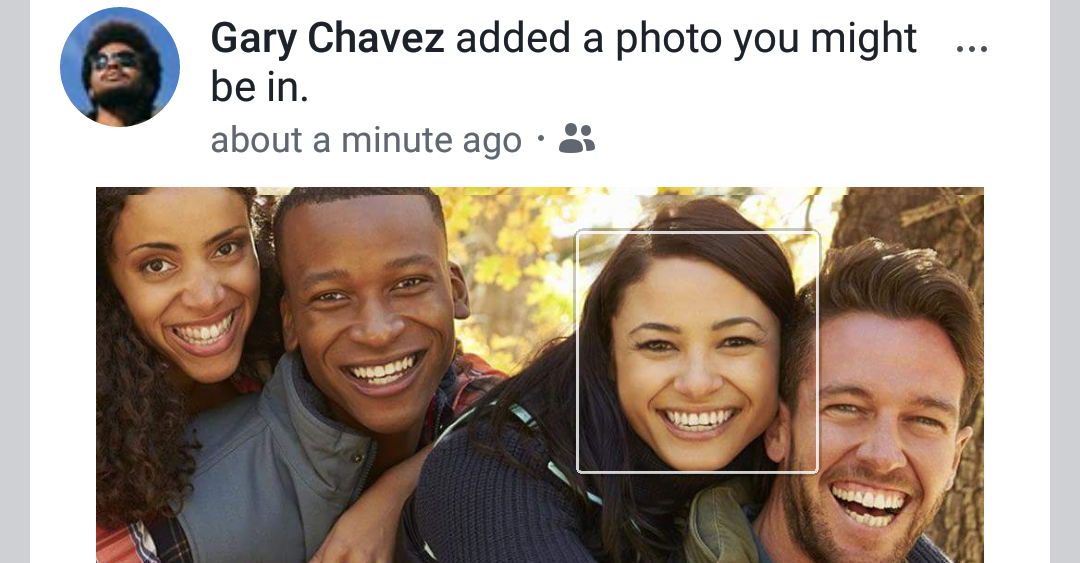
Когда вы загружаете фотографию на Facebook, сервис предлагает вам отметить на ней друга. При этом ваш друг действительно присутствует на фотографии, а соцсеть просто ждёт, что вы подтвердите это. Именно так работает механизм сканирования и распознавания лиц, реализованный площадкой Цукерберга. И именно этим недовольны жители Иллинойса.

Подпишитесь на новости

Opera добавила локальный ИИ: запросы обрабатываются на вашем компьютере

Нейросети в браузере необязательно кормить данными через чужой сервер. Opera представила раннюю версию поддержки WebAI — предложенного веб-стандарта, который позволяет сайтам и расширениям использовать ИИ-модели на компьютере пользователя. Первой площадкой стал Opera One, позднее возможности появятся в Opera GX и Neon.

О запуске и принципах работы компания рассказала в официальном анонсе.

WebAI рассчитан на разные модели, включая Gemma от Google. На совместимых яблочных компьютерах поддерживается и локальная фундаментальная модель Apple. Привязки к единственному поставщику не предполагается.

Есть генерация текста, классификация контента и анализ связей между фрагментами информации. Разработчики смогут добавлять такие функции без собственной серверной ИИ-инфраструктуры и оплаты каждого облачного запроса. Пользователю для локального выполнения не нужна подписка на внешний ИИ-сервис.

Функция включается добровольно. Вычисления происходят на устройстве, поэтому обрабатываемые локальной моделью данные не требуется отправлять облачному провайдеру.

Расплата за независимость от облака очевидная — нагрузка на компьютер. Скорость зависит от железа.

RSS: Новости на портале Anti-Malware.ru