



Баг Facebook позволял сайтам получать данные профилей пользователей

Баг Facebook позволял сайтам получать данные профилей пользователей

Баг Facebook позволял сайтам получать данные профилей пользователей

Facebook исправила очередной баг, который позволял любому веб-сайту извлекать некоторую информацию из профиля пользователя — например, «лайки» и интересы. При этом пользователь ничего не знал о таком сборе данных.

Проблему обнаружил Рон Масас, исследователь в области кибербезопасности из компании Imperva. Специалист обратил внимание, что данные профилей социальной сети недостаточно хорошо защищены от CSRF-атак.

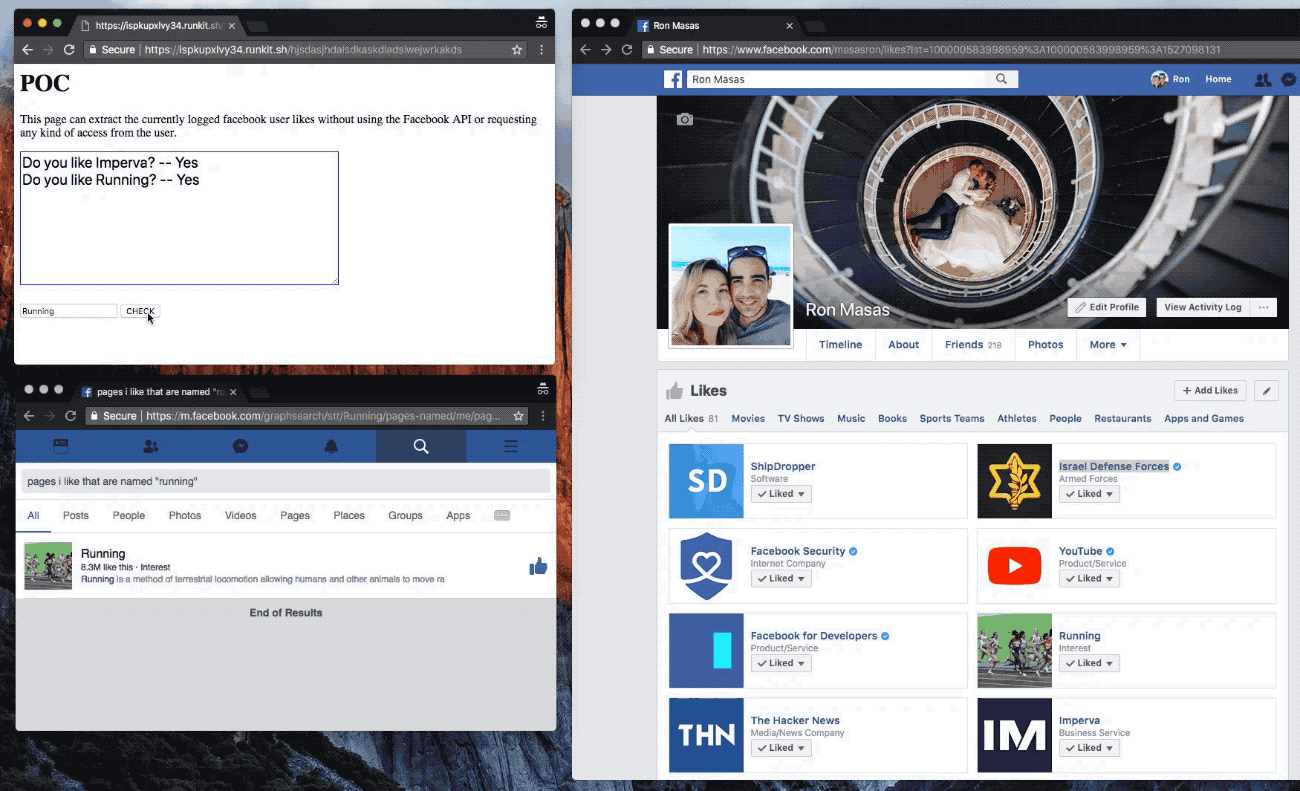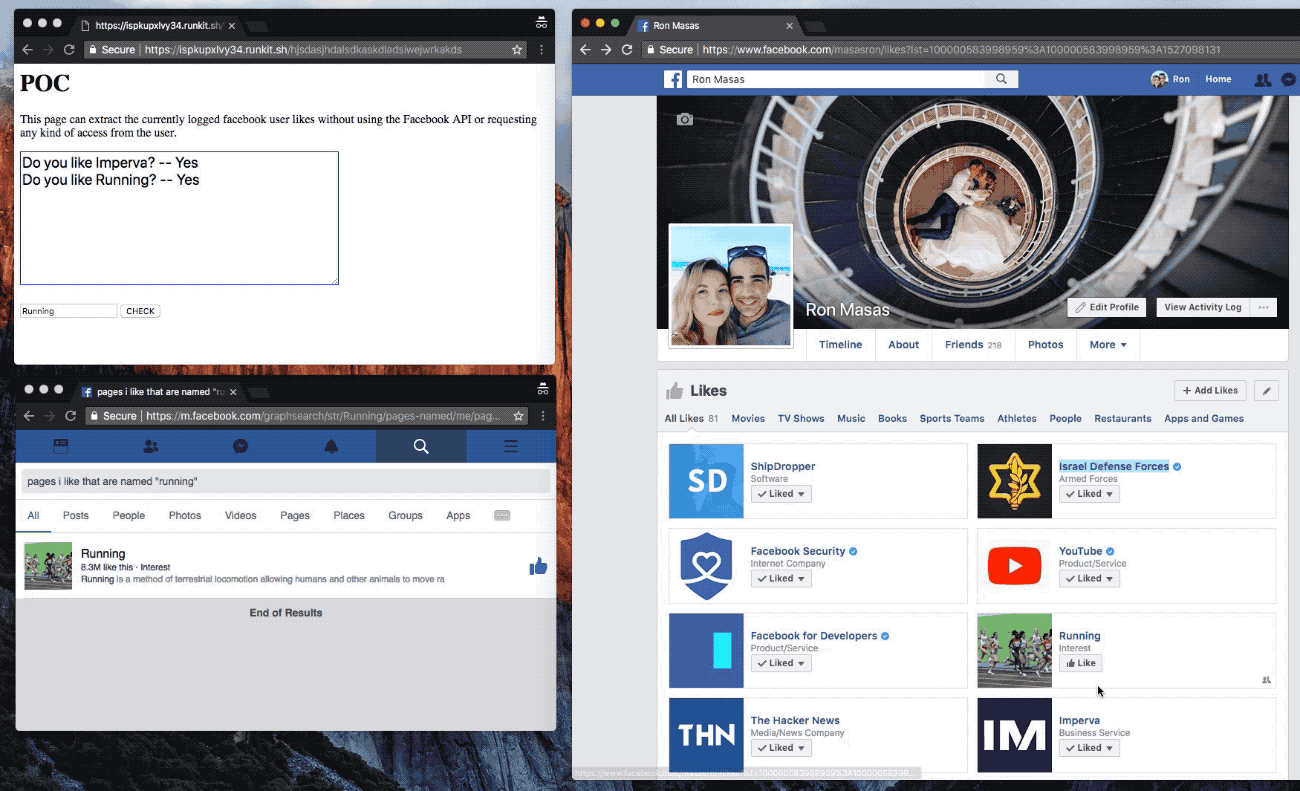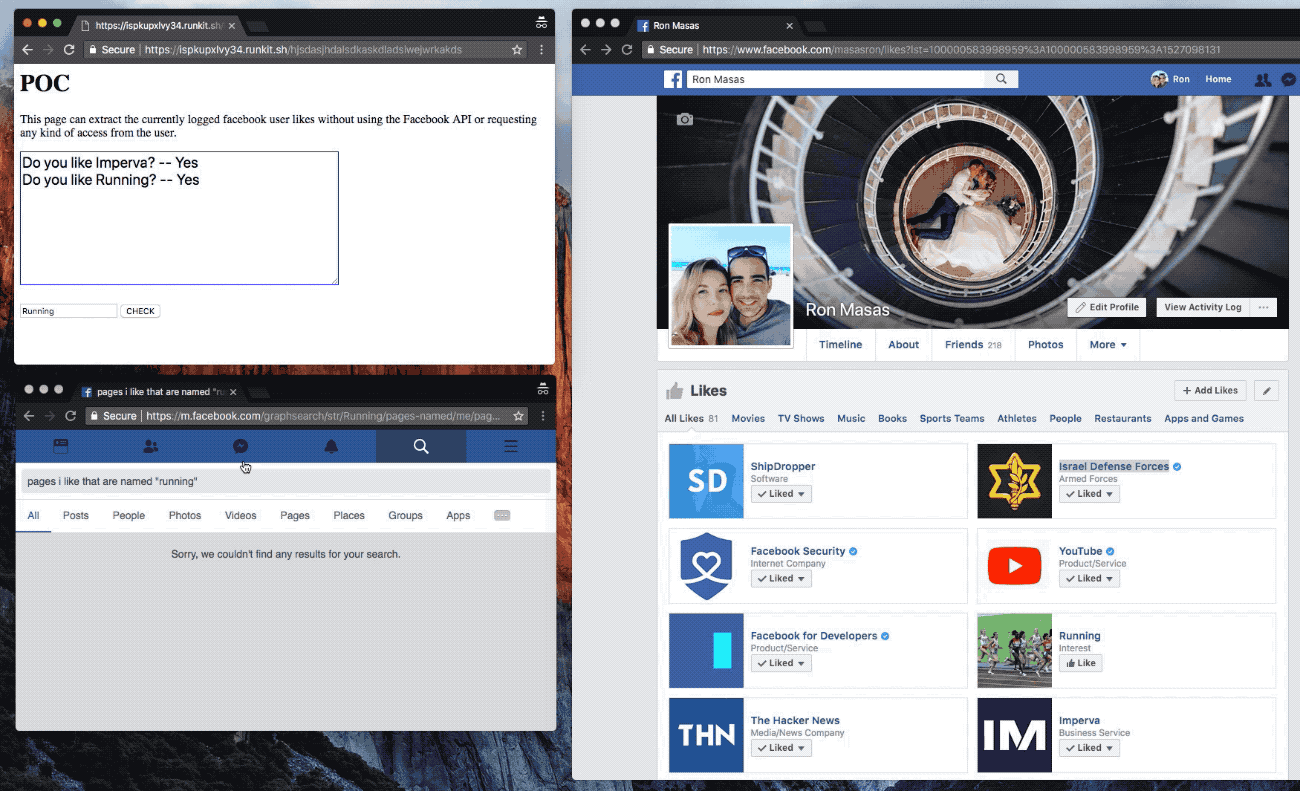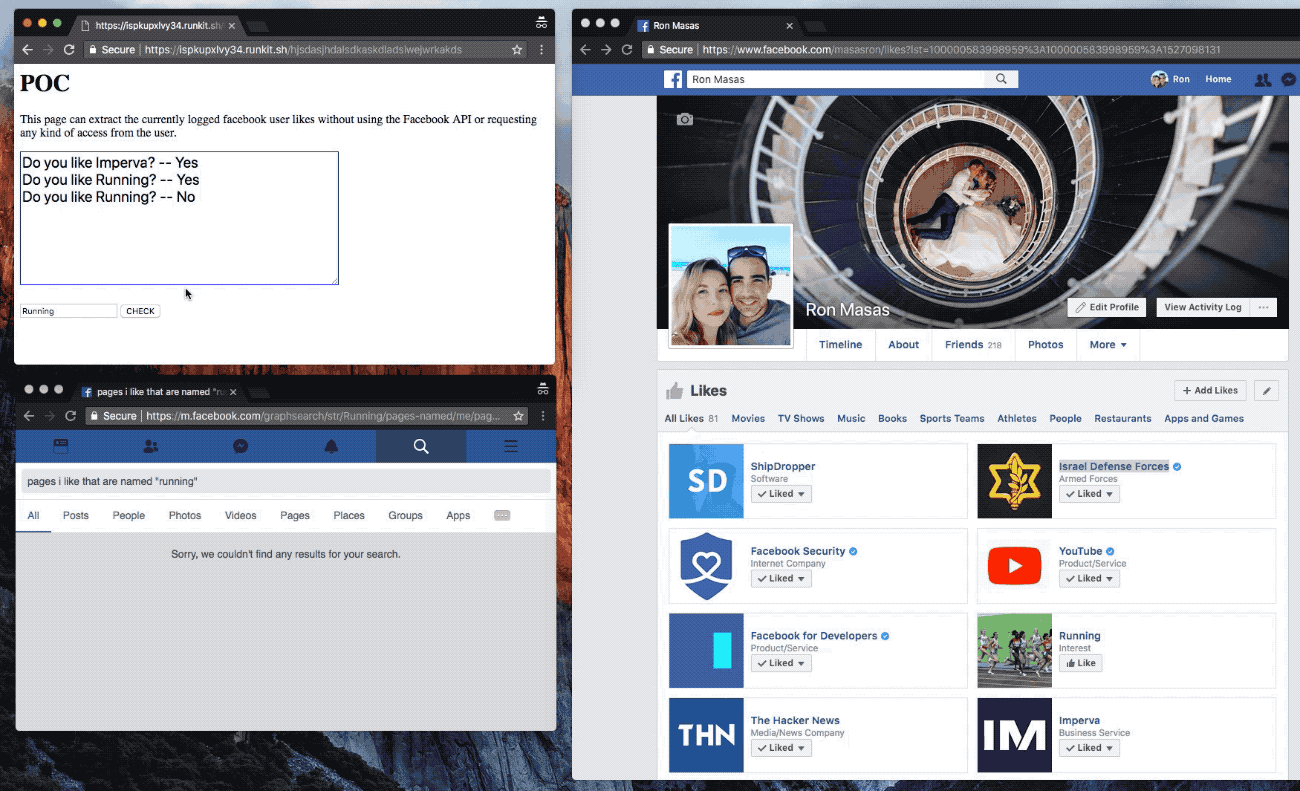
Другими словами, любой веб-ресурс мог тайно получить некий набор данных вашей учетной записи на Facebook в другой вкладке браузера. Масас продемонстрировал, как злонамеренный сайт может встроить IFRAME, чтобы тайно собирать информацию.

«Такая техника позволяет информации пользователя переходить от одного домена к другому. Это значит, что атакующий потенциально мог собирать информацию о пользователе социальной сети и его друзьях, если этот юзер посетит определенный сайт», — говорит исследователь.

Вредоносный сайт в этом случае мог инициировать несколько поисковых запросов Facebook в новой вкладке браузера. Ответы на эти запросы могли содержать значения «да» и «нет» — например: «пользователю нравится данная страница?» > «да».

Масас также отметил, что запросы могли возвращать и более сложные значения — друзей определенного пользователя (включая имена), публикации пользователя с определенными ключевыми словами и тому подобное.

«Уязвимость раскрывала интересы пользователя и его друзей, даже если его настройки приватности позволяли видеть их только друзьям», — объясняет специалист.

Imperva сообщила Facebook о проблеме в мае, после чего социальная сеть быстро приняла меры, реализовав защиту от атак CSRF. Исследователи получили по $8 000 за найденную брешь.

Claude помог хакерам пробраться во внутренний репозиторий OpenAI

Команда белых хакеров превратила загрузку одной картинки на официальном форуме OpenAI в пропуск к корпоративным аккаунтам ChatGPT, Codex и закрытому репозиторию компании. Взлом занял менее трёх суток, а значительную часть работы помог выполнить ИИ.

Как рассказали исследователи HackTron AI, точкой входа стал форум community.openai.com на платформе Discourse.

При загрузке изображений он использовал ImageMagick и библиотеку libheif, в которой обнаружилось переполнение буфера. Специально подготовленный HEIC-файл позволил удалённо выполнить код и получить административный доступ к форуму.

На этом цепочка только разогрелась. Исследователи воспользовались отдельной ошибкой в системе единого входа OpenAI: токены аутентификации форума подходили для ChatGPT и Codex. Среди них оказались токены сотрудников компании.

Через скомпрометированный аккаунт разработчика команда добралась до внутреннего монорепозитория OpenAI на GitHub. Чтобы доказать доступ и не устраивать экскурсию по чужому коду, специалисты создали безопасный тестовый pull request, после чего остановили проверку и сообщили о проблеме.

В роли помощников выступили модели Claude Opus 4.8 и Opus 5. Первая исследовала уязвимость, но споткнулась о защитные механизмы. Более новая версия, по данным HackTron, помогла собрать рабочий эксплойт за несколько часов.

OpenAI устранила уязвимость в своей инфраструктуре примерно через 14 часов после отчёта, ограничила права токенов Community и отозвала затронутые сессии. Discourse отдельно исправила проблему обработки изображений.

За находку OpenAI выплатила исследователям $6500. Скромная сумма для цепочки, которая началась с картинки на форуме, а закончилась pull request во внутреннем репозитории.

RSS: Новости на портале Anti-Malware.ru