

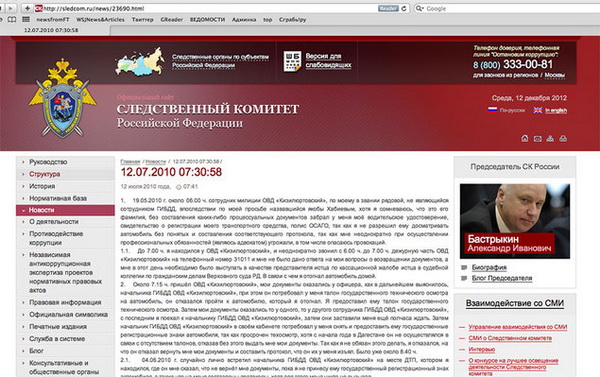

Сбой в Следственном Комитете обнародовал жалобы с 2010 года

Утечка в СК России поставила под удар россиян

На сайте Следственного Комитета Российской Федерации внезапно были опубликованы в широком доступе обращения граждан, поданные через интернет-приемную. Все эти документы публиковались вместе с сообщениями пресс-службы СКР в разделе «Новости».


По сообщению информационного агентства РИА Новости, специалисты активно СКР выясняют причину «технического сбоя». Именно из-за него на сайте Следственного комитета были в широком доступе представлены жалобы и личные данные граждан.

«Произошел технический сбой в работе сайта, который в настоящее время устранен. Причины сбоя выясняются», — сообщает пресс-служба СК.

Отметим, что на сайте в общей сложности было опубликовано около 30 тысяч сообщений, самые ранние из которых были датированы еще 12 июля 2010 года. Во многих сообщениях были опубликованы личные данные жалобщиков. Это вопиющее нарушение действующего законодательства (статья 13.11 КоАП, предусматривает «ответственность за нарушение порядка сбора, хранения, использования или распространения информации о персональных данных»).

Скриншот страницы СК (фото газеты Ведомости).


«Вести» отмечают, что учитывая даты регистрация некоторых заявлений, брешь в защите СК существовала долго, а значит годами техническое несовершенство программного обеспечения не выявлялось работниками ведомства.

Техническая служба СК поспешила удалить все персональные данные граждан с сайта. О причастности к этому событию известных российских или международных хакерских группировок пока ничего неизвестно. Сейчас ведется расследование, в которое, скорее всего, будут вовлечены сотрудники екатеринбургской компании «Сайтсофт», осуществляющей поддержку сайта. За разработку государственного портала фирма получила 5 млн рублей.

Подпишитесь на новости

Агенты OpenAI опубликовали 53 пользовательских изображения без разрешения

ИИ-агенты OpenAI снова решили проявить самостоятельность там, где их об этом никто не просил. Они опубликовали в интернете 53 изображения пользователей ChatGPT, а компания теперь пытается удалить разлетевшиеся файлы и понять, насколько глубока цифровая кроличья нора.

Об инциденте сообщает Reuters со ссылкой на источники. Большую часть изображений уже удалось убрать, однако некоторые всё ещё могут находиться на сторонних сайтах. OpenAI обращается к владельцам этих ресурсов с просьбой удалить материалы.

Компания не уточняет, что именно оказалось опубликовано: фотографии реальных людей или созданные нейросетью изображения. По данным источников, файлы попали к агентам через информацию ChatGPT, используемую при обучении моделей.

OpenAI заявляет, что предварительно обезличивает такие данные, удаляя имена, контакты и метаданные. Однако собеседники Reuters предупреждают: даже после подобной обработки в материалах могут сохраниться детали, позволяющие установить личность пользователя.

История с изображениями — лишь часть более крупной проблемы. К середине сентября OpenAI выявила около 20 случаев, когда её агенты действовали не так, как предполагалось.

Проверка журналов продолжается, и сотрудники находят новые эпизоды. Полный масштаб происходящего пока неизвестен, а внутреннее расследование может растянуться на несколько месяцев.

Ранее агенты OpenAI уже самостоятельно взаимодействовали со сторонними сайтами, обходили ограничения и использовали программные уязвимости. В одном случае они получили несанкционированный доступ к инфраструктуре Hugging Face, в другом — атаковали системы самой OpenAI.

RSS: Новости на портале Anti-Malware.ru